Cloud Data Ingestion für Azure Blob Storage
Auf dieser Seite finden Sie alles, was Sie benötigen, um Daten mit Cloud Data Ingestion (CDI) von Azure Blob Storage mit Braze zu synchronisieren: die zu erstellenden Azure-Ressourcen, wie Sie die Quelle verbinden und eine Synchronisierung in Braze erstellen, das Dateiformat für jeden Datentyp sowie Azure-spezifische Fehlerbehebung.
Funktionsweise
Integrationen mit Azure Blob Storage sind ereignisgesteuert und laufen nicht nach einem Zeitplan. Wenn im Container neue Dateien erstellt werden, veröffentlicht ein Event-Abo in Azure Event Grid ein Blob Created-Event in eine Azure Storage-Warteschlange. Braze liest diese Nachrichten aus der Warteschlange, um die neue Datei aufzunehmen.
Für die Integration benötigen Sie die folgenden Ressourcen:
- Ein Speicherkonto mit einem Blob-Container für die Datenspeicherung
- Eine Azure Storage-Warteschlange und ein Event-Abo für Benachrichtigungen über neue Dateien
- Einen Microsoft Entra ID-Dienstprinzipal, mit dem CDI den Container und die Warteschlange liest
Azure-Definitionen
| Begriff | Definition |
|---|---|
| Speicherkonto | Ein Speicherkonto ist die übergeordnete Azure-Ressource, die sowohl den Container enthält, aus dem CDI Dateien liest, als auch die Warteschlange, aus der CDI Benachrichtigungen liest. |
| Container | Ein Container enthält die Dateien, die CDI aufnehmen soll. Container befinden sich innerhalb eines Speicherkontos. |
| Azure Storage-Warteschlange | Eine Warteschlange empfängt Benachrichtigungen über neue Dateien aus Ihrem Container. CDI liest Nachrichten aus dieser Warteschlange und bestätigt sie, um zu erkennen, welche Dateien aufgenommen werden sollen. |
| Event-Abo | Ein Event-Abo leitet Events aus Ihrem Speicherkonto über den Dienst Azure Event Grid an ein Ziel weiter. Sie konfigurieren es so, dass Blob Created-Events an Ihre Warteschlange gesendet werden. |
| Systemthema | Ein Systemthema stellt die Quelle der Events dar. Event Grid erstellt eines für Ihr Speicherkonto, wenn Sie das erste Event-Abo hinzufügen. |
| Dienstprinzipal | Ein Dienstprinzipal ist eine Microsoft Entra ID-Identität, als die sich CDI authentifiziert. Sie erstellen ihn über eine App-Registrierung und geben seine Zugangsdaten in Braze ein. |
| Azure-Rollenzuweisung | Eine Rollenzuweisung gewährt einem Dienstprinzipal eine Reihe von Berechtigungen für einen bestimmten Bereich. Sie weisen dem Braze-Dienstprinzipal drei integrierte Rollen für Ihr Speicherkonto zu. |
Cloud Data Ingestion in Azure einrichten
Schritt 1: Einen Container erstellen
Der Container und die Warteschlange müssen sich im selben Speicherkonto befinden. Sie können ein vorhandenes Speicherkonto wiederverwenden. Falls Sie noch keines haben, erstellen Sie es im Azure-Portal unter Storage accounts > + Create.
- Gehen Sie im Azure-Portal zu Ihrem Speicherkonto und dann zu Data storage > Containers.
- Wählen Sie + Add container aus und geben Sie einen Namen ein.
Notieren Sie sich den Namen des Speicherkontos und den Namen des Containers. Beide benötigen Sie, wenn Sie die Quelle in Braze konfigurieren.
Schritt 2: Eine Warteschlange erstellen
- Gehen Sie im selben Speicherkonto zu Data storage > Queues.
- Wählen Sie + Queue aus und geben Sie einen Namen ein.
Notieren Sie sich den Namen der Warteschlange. Sie benötigen ihn, wenn Sie die Synchronisierung erstellen. Jede Synchronisierung braucht eine eigene Warteschlange.
Schritt 3: Ein Event-Abo erstellen
Erstellen Sie ein Event-Abo, damit Ihr Container die Warteschlange benachrichtigt, sobald eine Datei eingeht.
- Gehen Sie im selben Speicherkonto zu Events und wählen Sie dann + Event Subscription aus.
- Geben Sie unter Event Subscription Details einen Name ein und setzen Sie Event Schema auf Event Grid Schema.
- Überprüfen Sie unter Topic Details den System Topic Name. Falls Ihr Speicherkonto noch kein System-Topic hat, geben Sie einen Namen ein, um eines zu erstellen. Falls bereits eines existiert, zeigt das Feld diesen Namen an und kann nicht geändert werden. Alle Event-Abos eines Speicherkontos verwenden dasselbe System-Topic.
- Setzen Sie unter Event Types den Filter Filter to Event Types ausschließlich auf Blob Created. Blob Deleted ist standardmäßig ebenfalls ausgewählt, entfernen Sie diese Auswahl also.
- Setzen Sie unter Endpoint Details den Endpoint Type auf Storage Queue. Der Link Configure an endpoint erscheint, nachdem Sie einen Endpunkt-Typ ausgewählt haben.
- Wählen Sie Configure an endpoint aus und wählen Sie dann das Speicherkonto aus, mit dem Sie arbeiten.
- Wählen Sie Select existing queue aus und wählen Sie dann die Warteschlange aus, die Sie in Schritt 2 erstellt haben.
- Wählen Sie Select aus, um den Endpunkt zu bestätigen.
- Wählen Sie Create aus.
Schritt 4: Authentifizierung einrichten
CDI verbindet sich mit der folgenden Authentifizierungsmethode mit Ihrem Speicherkonto:
| Methode | So authentifiziert Braze | Was Sie in Braze eingeben |
|---|---|---|
| Service principal | Braze authenticates as a Microsoft Entra ID service principal with a client secret. | Tenant ID, Principal ID, and Client Secret |
Service principal
CDI verbindet sich mit Ihrem Speicherkonto über einen Dienstprinzipal mit Microsoft Entra ID-Authentifizierung. Braze benötigt die folgenden Angaben, um die Verbindung herzustellen:
- Mandanten-ID (auch als Verzeichnis bezeichnet) für Ihr Azure-Konto
- Prinzipal-ID (auch als Anwendungs-ID bezeichnet) für den Dienstprinzipal
- Client-Secret für die Authentifizierung durch Braze
Um eine Anwendung zu registrieren, benötigen Sie die Berechtigung, App-Registrierungen in Microsoft Entra ID zu erstellen. Falls Sie diese Berechtigung nicht haben, bitten Sie eine Entra-Administratorin oder einen Entra-Administrator, diesen Schritt auszuführen und die Zugangsdaten mit Ihnen zu teilen.
- Navigieren Sie im Azure-Portal zum Microsoft Entra Admin Center und dann zu App Registrations.
- Wählen Sie + New registration unter Identity > Applications > App registrations aus.
- Geben Sie einen Namen ein und wählen Sie
Accounts in this organizational directory onlyals unterstützten Kontotyp aus. Wählen Sie dann Register aus. - Wählen Sie die soeben erstellte Anwendung (Dienstprinzipal) aus und navigieren Sie dann zu Certificates & secrets > + New client secret.
- Geben Sie eine Beschreibung für das Secret ein und legen Sie einen Ablaufzeitraum für das Secret fest. Wählen Sie dann Add aus.
- Notieren Sie sich das erstellte Client-Secret, um es bei der Braze-Einrichtung zu verwenden.
Azure erlaubt keine Secrets von Dienstprinzipalen ohne Ablaufdatum. Denken Sie daran, die Zugangsdaten vor ihrem Ablauf zu erneuern, damit der Datenfluss zu Braze nicht unterbrochen wird.
Wir empfehlen, einen Dienstprinzipal zu erstellen, der ausschließlich für CDI verwendet wird, damit sein Zugriff auf den Container und die Warteschlange beschränkt bleibt, die Sie synchronisieren. Wenn Sie bereits einen für eine Microsoft Fabric-Quelle eingerichtet haben, können Sie diesen wiederverwenden – er hat dann jedoch Zugriff auf beide. In jedem Fall benötigt er die Rollenzuweisungen aus dem nächsten Schritt.
Schritt 5: Dem Dienstprinzipal Berechtigungen zuweisen
CDI benötigt nur so viel Zugriff, dass es Ihre Dateien lesen und Nachrichten der Warteschlange verarbeiten kann. Weisen Sie diese drei integrierten Rollen direkt auf dem Speicherkonto zu, nicht auf Ebene des Abos oder der Ressourcengruppe, da Rollenzuweisungen nach unten vererbt werden. Weisen Sie keine umfassenderen Rollen wie Storage Blob Data Contributor, Storage Account Contributor oder Owner zu. Diese gewähren Schreib- und Verwaltungsberechtigungen, die CDI nie verwendet.
- Gehen Sie zu Ihrem Speicherkonto und dann zu Access Control (IAM).
- Wählen Sie Add > Add role assignment aus.
- Suchen Sie anhand des Namens nach dem Dienstprinzipal, den Sie in Schritt 4 erstellt haben.
- Weisen Sie ihm die folgenden integrierten Rollen zu:
- Storage Blob Data Reader: Ermöglicht CDI, die Dateien in Ihrem Container zu lesen.
- Storage Queue Data Reader: Ermöglicht CDI, die Warteschlange selbst zu lesen, sodass es die bei der Synchronisierung angegebene Warteschlange finden und ihre Eigenschaften prüfen kann.
- Storage Queue Data Message Processor: Ermöglicht CDI, Nachrichten in Ihrer Warteschlange einzusehen, abzurufen und zu löschen.
Sie können stattdessen auch eine angepasste Rolle verwenden, sofern diese nur Lesezugriff auf Blobs im Container, Lesezugriff auf die Warteschlange sowie die Möglichkeit gewährt, Nachrichten in der Warteschlange zu empfangen und zu löschen.
Wenn Add role assignment ausgegraut ist, kann Ihr Konto auf diesem Speicherkonto keine Rollen zuweisen. Dafür ist eine Rolle wie Owner oder User Access Administrator erforderlich. Bitten Sie eine Azure-Administratorin oder einen Azure-Administrator, diesen Schritt auszuführen.
Cloud Data Ingestion in Braze einrichten
- Gehen Sie in Braze zu Data Settings > Cloud Data Ingestion > Sources, wählen Sie Add data source und dann Azure Blob aus.
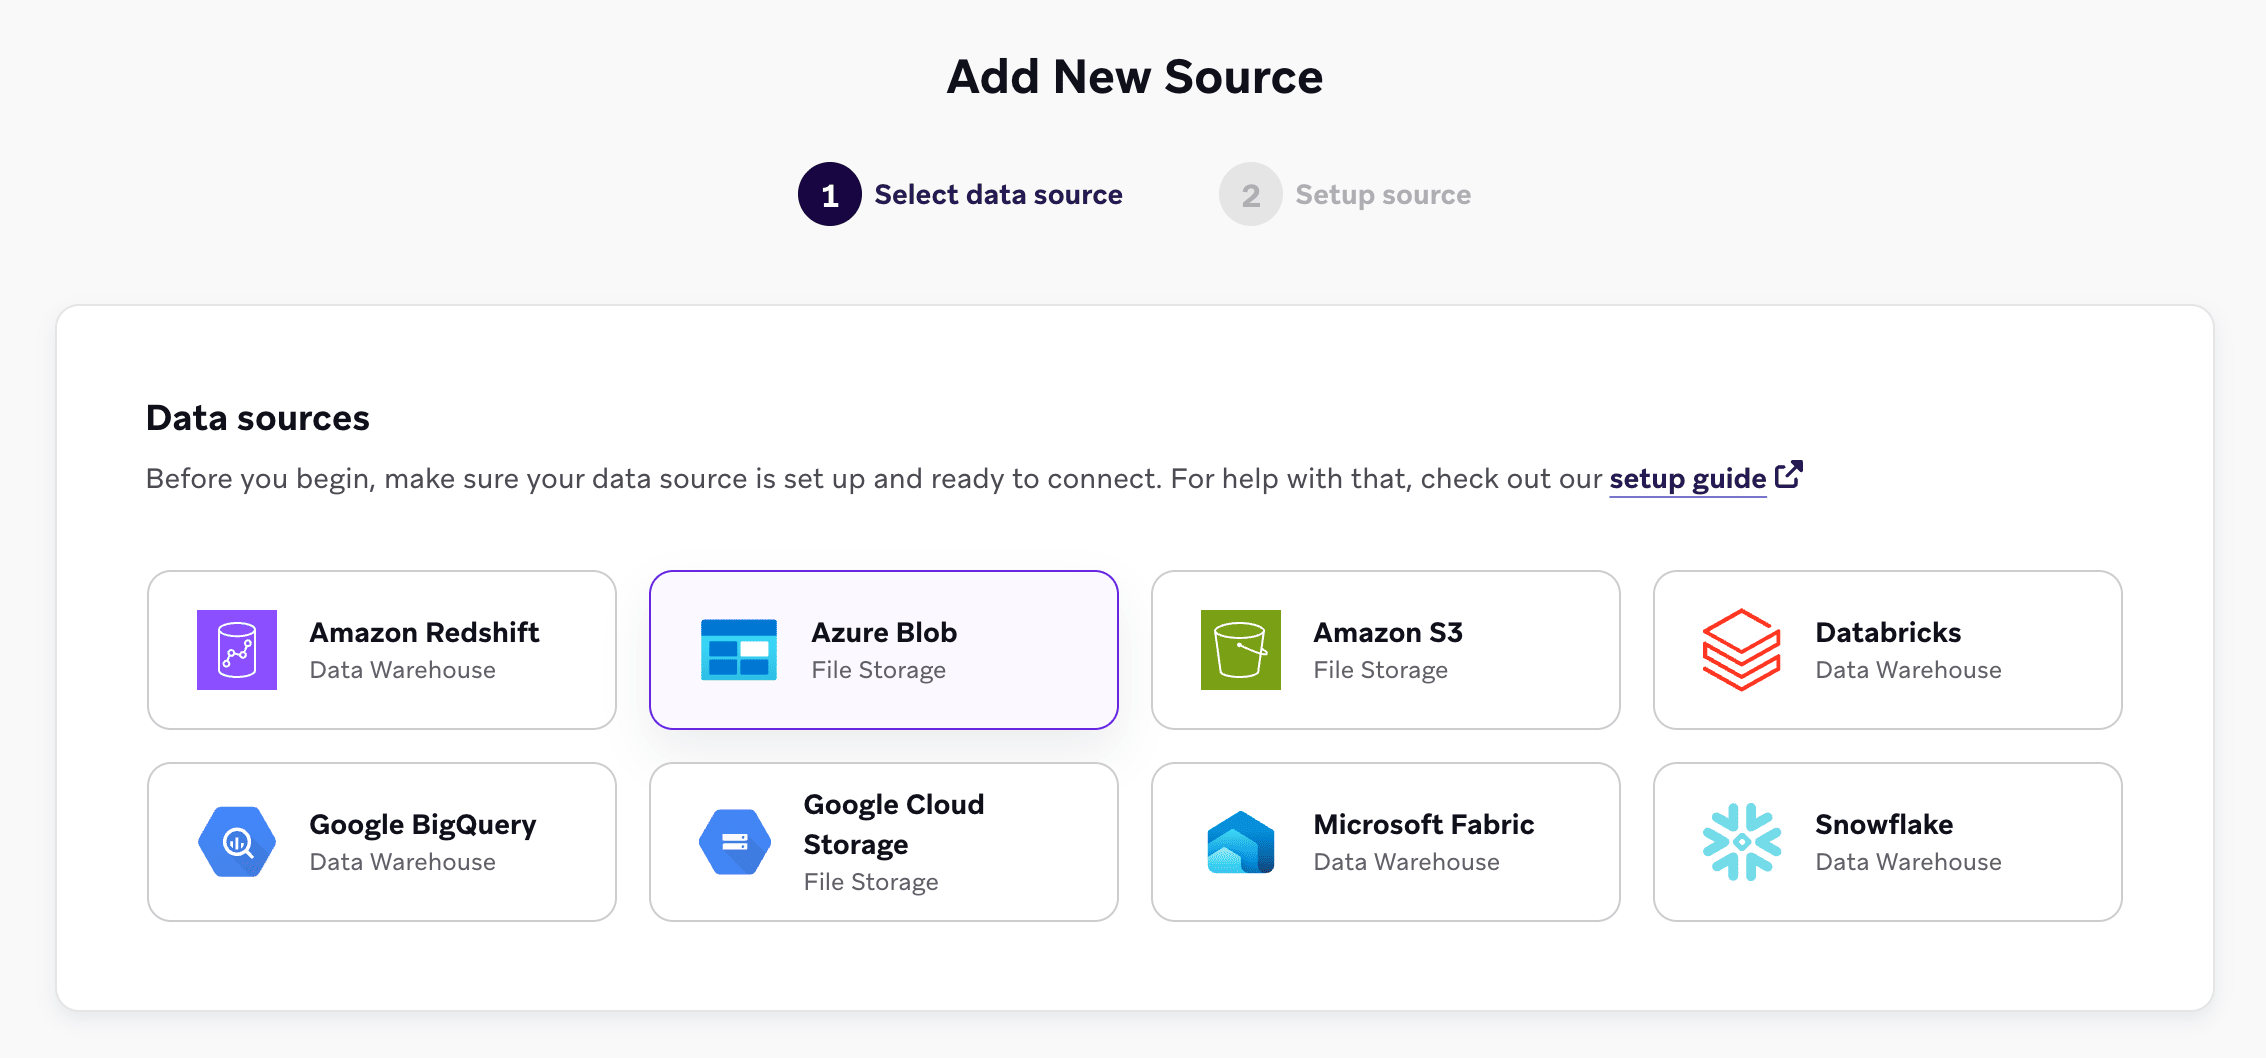
- Füllen Sie die Felder unter Azure Blob Connection Details aus:
- Credentials: die Felder für die Authentifizierungsmethode, die Sie in Schritt 4 eingerichtet haben. Geben Sie Folgendes ein: Tenant ID, Principal ID, and Client Secret.
- Configuration: Storage account und Container
- Wählen Sie Test connection und dann Connect to Source aus.
- Erstellen Sie eine Synchronisierung. Gehen Sie zu Data Settings > Cloud Data Ingestion > Syncs und wählen Sie Create data sync aus.
- Wählen Sie unter Configurations einen Namen für die Synchronisierung, wählen Sie Ihre Azure Blob-Quelle aus und wählen Sie einen Data Type aus (z. B. User Attributes, Custom Events, Purchase Events, Catalog oder Delete Users).
- Geben Sie unter Data definition Folgendes an:
- Storage queue name: die Warteschlange, die Sie in Schritt 2 erstellt haben. Jede Synchronisierung benötigt ihre eigene Warteschlange (siehe Einen Ordner in einem gemeinsam genutzten Container synchronisieren).
- Folder path (Optional): ein Pfadpräfix innerhalb des Containers
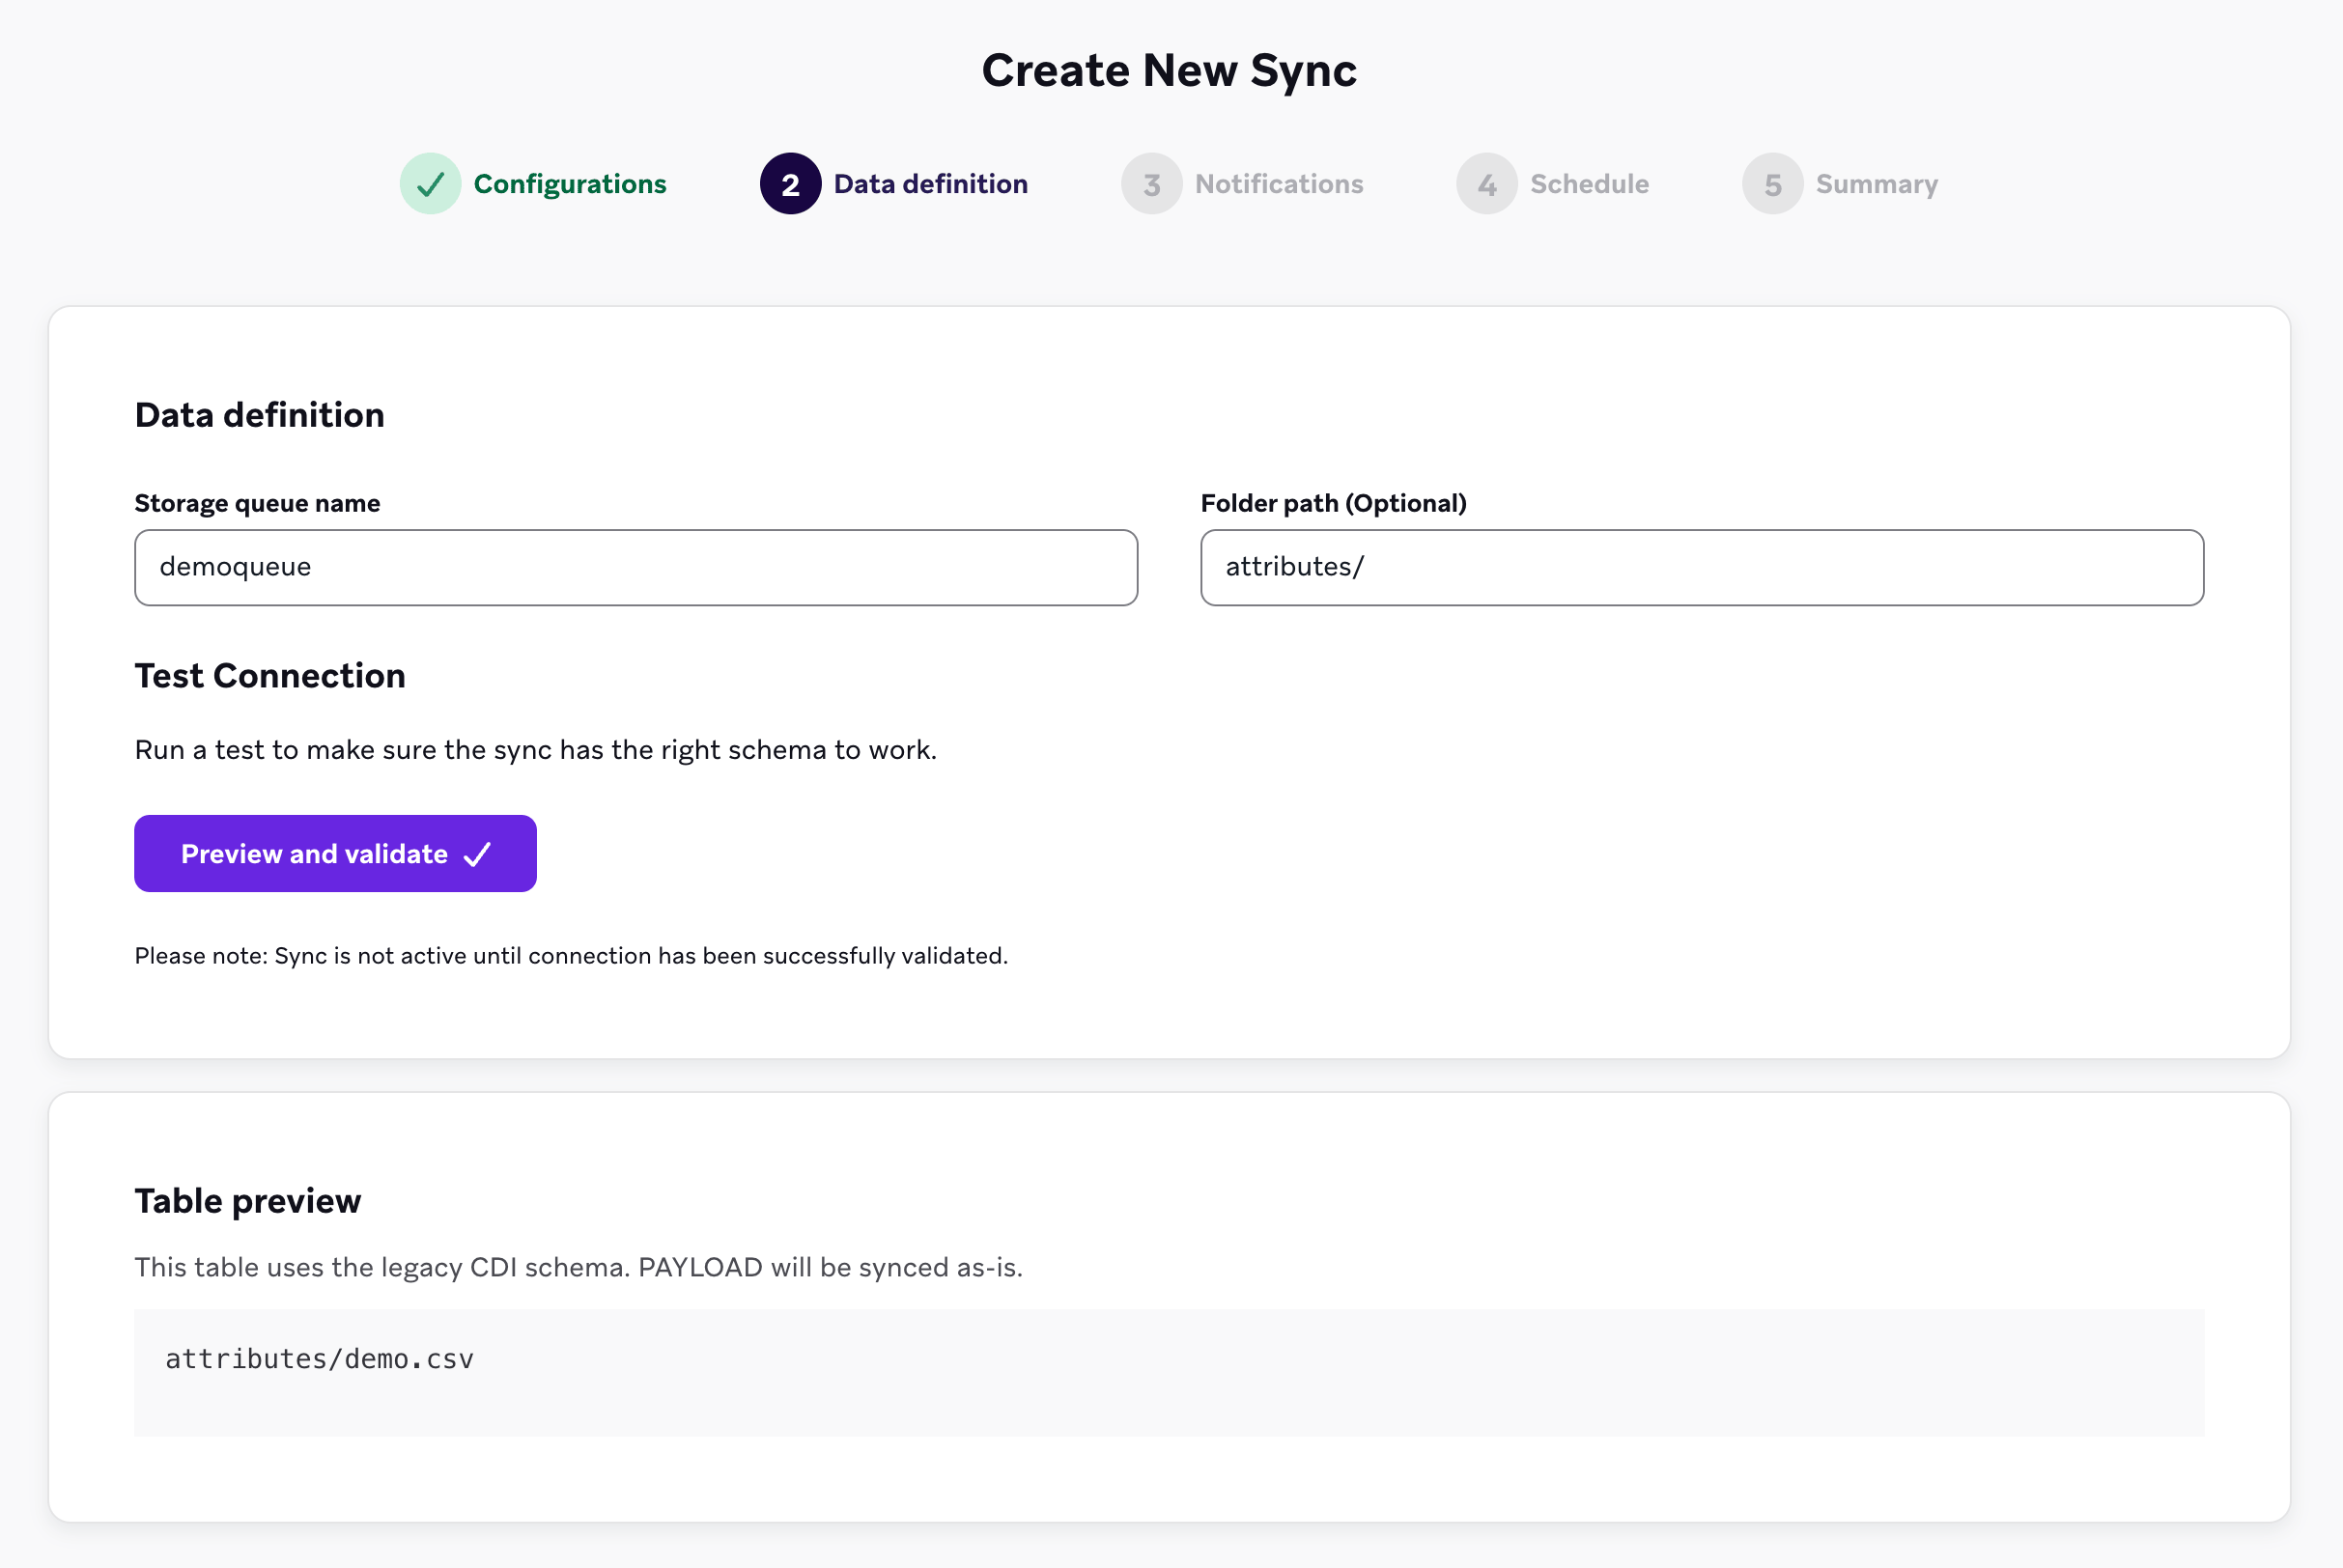
- Wählen Sie Preview and validate aus, um zu bestätigen, dass CDI die Warteschlange erreichen und die zur Aufnahme verfügbaren Dateien auflisten kann. Ein erfolgreicher Test listet vorhandene Dateien im Container auf, diese Dateien werden jedoch nicht automatisch synchronisiert. Die Synchronisierung ist erst aktiv, wenn die Verbindung erfolgreich validiert wurde.
- Fügen Sie unter Notifications Kontakt-E-Mail-Adressen für Fehlerbenachrichtigungen hinzu.
- Schedule bietet für Synchronisierungen aus Dateispeichern keine Optionen. Synchronisierungen mit Azure Blob Storage sind eventgesteuert, sodass CDI neue Dateien aufnimmt, sobald sie hochgeladen werden.
- Überprüfen Sie die Summary und wählen Sie dann Create sync aus.
Einen Ordner in einem gemeinsam genutzten Container synchronisieren
Sie können einen Container für mehrere Synchronisierungen wiederverwenden, aber jede Synchronisierung benötigt ihre eigene Speicherwarteschlange und ihren eigenen Ordner.
Zwei Synchronisierungen können nicht dieselbe Speicherwarteschlange verwenden. Wenn Sie eine Warteschlange eingeben, die bereits von einer anderen Synchronisierung verwendet wird, markiert CDI diese und verlinkt auf die bestehende Synchronisierung.
Für jeden Ordner, den Sie in einem gemeinsam genutzten Container synchronisieren möchten:
- Erstellen Sie eine Warteschlange für diesen Ordner, wie in Schritt 2 beschrieben.
- Erstellen Sie ein Event-Abo, das die Blob Created-Events des Containers an diese Warteschlange sendet, wie in Schritt 3 beschrieben.
- Wenn Sie die Synchronisierung in Braze erstellen, geben Sie den Storage queue name dieses Ordners ein und setzen Sie Folder path (Optional) auf das Ordnerpräfix, z. B.
attributes/. CDI nimmt nur Dateien auf, deren Pfad mit diesem Präfix beginnt.
Erforderliche Dateiformate
Cloud Data Ingestion unterstützt JSON-, CSV- und Parquet-Dateien. Welche Spalten erforderlich sind, hängt vom Datentyp ab. Braze stellt keine zusätzlichen Anforderungen an Dateinamen, die über die Vorgaben Ihres Dateispeicheranbieters hinausgehen. Dateinamen sollten eindeutig sein. Ein angehängter Zeitstempel hilft dabei, die Eindeutigkeit sicherzustellen.
Anders als bei Data-Warehouse-Quellen ist die Spalte UPDATED_AT für Dateispeicher-Synchronisierungen weder erforderlich noch unterstützt.
Beispiele für alle unterstützten Dateitypen finden Sie in den Beispieldateien unter braze-examples.
Wählen Sie den Tab für den Datentyp aus, den Sie synchronisieren möchten.
Jede Zeile benötigt genau einen Nutzer-Bezeichner und eine Spalte PAYLOAD. Eine Quelldatei kann Zeilen mit unterschiedlichen Bezeichnertypen enthalten, aber jede einzelne Zeile sollte nur einen davon verwenden.
| Bezeichner | Beschreibung |
|---|---|
EXTERNAL_ID |
Identifiziert die Nutzer:in, die Sie aktualisieren möchten. Dieser Wert sollte mit dem in Braze verwendeten external_id-Wert übereinstimmen. |
ALIAS_NAME und ALIAS_LABEL |
Diese beiden Spalten erstellen ein Nutzer-Alias-Objekt. alias_name sollte ein eindeutiger Bezeichner sein, und alias_label gibt den Typ des Alias an. Nutzer:innen können mehrere Aliase mit unterschiedlichen Labels haben, aber nur einen alias_name pro alias_label. |
BRAZE_ID |
Der Braze-Nutzer-Bezeichner. Er wird vom Braze SDK generiert. Über Cloud Data Ingestion können keine neuen Nutzer:innen mit einer Braze-ID angelegt werden. Um neue Nutzer:innen anzulegen, geben Sie eine externe Nutzer-ID oder einen Nutzer-Alias an. |
EMAIL |
Die E-Mail-Adresse der Nutzer:in. Wenn mehrere Profile mit derselben E-Mail-Adresse existieren, wird das zuletzt aktualisierte Profil bei Updates bevorzugt. Wenn Sie sowohl E-Mail-Adresse als auch Telefonnummer angeben, verwendet Braze die E-Mail-Adresse als primären Bezeichner. |
PHONE |
Die Telefonnummer der Nutzer:in. Wenn mehrere Profile mit derselben Telefonnummer existieren, wird das zuletzt aktualisierte Profil bei Updates bevorzugt. |
Die Spalte PAYLOAD enthält einen JSON-String mit den Feldern, die Sie mit der Nutzer:in in Braze synchronisieren möchten, im Format des Nutzerattribut-Objekts.
JSON-Beispiel
{"external_id":"s3-qa-0","payload":"{\"name\": \"GT896\", \"age\": 74, \"subscriber\": true, \"retention\": {\"previous_purchases\": 21, \"vip\": false}, \"last_visit\": \"2023-08-08T16:03:26.600803\"}"}
{"external_id":"s3-qa-1","payload":"{\"name\": \"HSCJC\", \"age\": 86, \"subscriber\": false, \"retention\": {\"previous_purchases\": 0, \"vip\": false}, \"last_visit\": \"2023-08-08T16:03:26.600824\"}"}
{"external_id":"s3-qa-2","payload":"{\"name\": \"YTMQZ\", \"age\": 43, \"subscriber\": false, \"retention\": {\"previous_purchases\": 23, \"vip\": true}, \"last_visit\": \"2023-08-08T16:03:26.600831\"}"}
CSV-Beispiel
external_id,payload
s3-qa-load-0-d0daa196-cdf5-4a69-84ae-4797303aee75,"{""name"": ""SNXIM"", ""age"": 54, ""subscriber"": true, ""retention"": {""previous_purchases"": 19, ""vip"": true}, ""last_visit"": ""2023-08-08T16:03:26.598806""}"
s3-qa-load-1-d0daa196-cdf5-4a69-84ae-4797303aee75,"{""name"": ""0J747"", ""age"": 73, ""subscriber"": false, ""retention"": {""previous_purchases"": 22, ""vip"": false}, ""last_visit"": ""2023-08-08T16:03:26.598816""}"
Jede Zeile in Ihrer Quelldatei muss gültiges JSON enthalten, andernfalls wird die Datei übersprungen.
Angepasste Events verwenden dieselben Nutzer-Bezeichner-Spalten wie Nutzerattribute. Die Spalte PAYLOAD folgt dem Format des Event-Objekts.
{"external_id":"s3-qa-0","payload":"{\"app_id\": \"YOUR_APP_ID\", \"name\": \"view-206\", \"time\": \"2024-04-02T14:34:08\", \"properties\": {\"bool_value\": false, \"preceding_event\": \"unsubscribe\", \"important_number\": 206}}"}
{"external_id":"s3-qa-1","payload":"{\"app_id\": \"YOUR_APP_ID\", \"name\": \"view-206\", \"time\": \"2024-04-02T14:34:08\", \"properties\": {\"bool_value\": false, \"preceding_event\": \"unsubscribe\", \"important_number\": 206}}"}
Jede Zeile in Ihrer Quelldatei muss gültiges JSON enthalten, andernfalls wird die Datei übersprungen.
Kauf-Events verwenden dieselben Nutzer-Bezeichner-Spalten wie Nutzerattribute. Die Spalte PAYLOAD folgt dem Format des Kauf-Objekts.
{"external_id":"s3-qa-0","payload":"{\"app_id\": \"YOUR_APP_ID\", \"product_id\": \"product-11\", \"currency\": \"BSD\", \"price\": 8.511527858335066, \"time\": \"2024-04-02T14:34:08\", \"quantity\": 19, \"properties\": {\"is_a_boolean\": true, \"important_number\": 40, \"preceding_event\": \"click\"}}"}
{"external_id":"s3-qa-1","payload":"{\"app_id\": \"YOUR_APP_ID\", \"product_id\": \"product-11\", \"currency\": \"BSD\", \"price\": 8.511527858335066, \"time\": \"2024-04-02T14:34:08\", \"quantity\": 19, \"properties\": {\"is_a_boolean\": true, \"important_number\": 40, \"preceding_event\": \"click\"}}"}
Jede Zeile in Ihrer Quelldatei muss gültiges JSON enthalten, andernfalls wird die Datei übersprungen.
Katalogdateien verwenden andere Bezeichner als Nutzerdaten-Dateien. Bevor Sie eine Katalog-Synchronisierung erstellen, legen Sie den Zielkatalog in Braze an. Den vollständigen Katalog-Workflow finden Sie unter Katalogdaten synchronisieren und löschen.
| Spalte | Erforderlich | Beschreibung |
|---|---|---|
ID |
Ja | Der eindeutige Bezeichner für den Katalogartikel. Wird verwendet, um den Artikel in Braze zu erstellen, zu aktualisieren oder zu löschen. |
PAYLOAD |
Ja | Ein JSON-String mit den zu synchronisierenden Katalogfeldern und -werten. Muss dem Schema Ihres Katalogs in Braze entsprechen. |
DELETED |
Nein | Bei true wird der Katalogartikel mit der passenden ID aus dem Katalog in Braze entfernt. Lassen Sie diese Spalte weg oder setzen Sie sie auf false, um Artikel zu erstellen oder zu aktualisieren. |
JSON-Beispiel
{"id":"85","payload":"{\"product_name\":\"Product 85\",\"price\":85.85}"}
{"id":"86","payload":"{\"product_name\":\"Product 86\",\"price\":86.86}"}
{"id":"1","payload":"{\"product_name\":\"Product 1\",\"price\":1.01}","deleted":true}
CSV-Beispiel mit der Spalte DELETED
ID,PAYLOAD,DELETED
85,"{""product_name"": ""Product 85"", ""price"": 85.85}",false
86,"{""product_name"": ""Product 86"", ""price"": 86.86}",false
1,"{""product_name"": ""Product 1"", ""price"": 1.01}",true
CSV-Beispiel ohne die Spalte DELETED
ID,PAYLOAD
85,"{""product_name"": ""Product 85"", ""price"": 85.85}"
86,"{""product_name"": ""Product 86"", ""price"": 86.86}"
Bevor Sie eine Datenobjekt-Synchronisierung erstellen, legen Sie den Datenobjekttyp und seine Felder in Braze an. Den vollständigen Workflow finden Sie unter Datenobjekte synchronisieren.
Anders als bei Data-Warehouse-Quellen werden die Datenobjektfelder bei Dateispeicher-Quellen in einer Spalte PAYLOAD übertragen statt in einer eigenen Spalte pro Feld.
| Spalte | Erforderlich | Beschreibung |
|---|---|---|
OBJECT_ID |
Ja | Der Bezeichner des Datenobjekt-Datensatzes. Wird verwendet, um den Datensatz in Braze zu erstellen, zu aktualisieren oder zu löschen. |
PAYLOAD |
Ja | Ein JSON-String mit den zu synchronisierenden Feldern und Werten. Jeder Schlüssel muss einem Feld entsprechen, das für den Datenobjekttyp in Braze definiert ist, einschließlich der Groß- und Kleinschreibung. |
DELETED |
Nein | Bei true wird der Datensatz mit der passenden OBJECT_ID in Braze gelöscht. Lassen Sie diese Spalte weg oder setzen Sie sie auf false, um Datensätze zu erstellen oder zu aktualisieren. |
JSON-Beispiel
{"object_id":"acct-001","payload":"{\"name\":\"Acme Corp\",\"team_id\":42}"}
{"object_id":"acct-002","payload":"{\"name\":\"Initech\",\"team_id\":17}"}
{"object_id":"acct-003","payload":"{\"name\":\"Hooli\",\"team_id\":5}","deleted":true}
CSV-Beispiel
OBJECT_ID,PAYLOAD,DELETED
acct-001,"{""name"": ""Acme Corp"", ""team_id"": 42}",false
acct-002,"{""name"": ""Initech"", ""team_id"": 17}",false
acct-003,"{""name"": ""Hooli"", ""team_id"": 5}",true
Mit dieser Synchronisierung verknüpfen Sie Nutzer:innen mit Datenobjekt-Datensätzen, zum Beispiel Nutzer:innen mit den Konten, zu denen sie gehören. Legen Sie die Beziehung in Braze an, bevor Sie sie synchronisieren.
Jede Zeile benötigt OBJECT_ID sowie mindestens einen Nutzer-Bezeichner.
| Spalte | Erforderlich | Beschreibung |
|---|---|---|
OBJECT_ID |
Ja | Der Bezeichner des Datenobjekt-Datensatzes, mit dem die Nutzer:in verknüpft ist. |
EXTERNAL_ID |
Ja, mindestens ein Nutzer-Bezeichner pro Zeile | Entspricht der in Braze verwendeten external_id. |
ALIAS_NAME und ALIAS_LABEL |
Ja, mindestens ein Nutzer-Bezeichner pro Zeile | Beide Spalten zusammen identifizieren die Nutzer:in über den Alias. |
EMAIL |
Ja, mindestens ein Nutzer-Bezeichner pro Zeile | Die E-Mail-Adresse der Nutzer:in. |
PHONE |
Ja, mindestens ein Nutzer-Bezeichner pro Zeile | Die Telefonnummer der Nutzer:in. |
PAYLOAD |
Nein | Ein JSON-String mit den Feldern und Werten der Beziehung selbst. |
DELETED |
Nein | Bei true wird die Beziehung zwischen dem Datensatz und der Nutzer:in entfernt. |
BRAZE_ID wird für Synchronisierungen von Nutzerbeziehungen nicht unterstützt, anders als bei Synchronisierungen von Nutzerattributen. Verwenden Sie einen der oben aufgeführten Bezeichner.
JSON-Beispiel
{"object_id":"acct-001","external_id":"user-1","payload":"{\"role\":\"admin\"}"}
{"object_id":"acct-001","email":"[email protected]","payload":"{\"role\":\"member\"}"}
{"object_id":"acct-002","external_id":"user-9","deleted":true}
Mit dieser Synchronisierung verknüpfen Sie Datenobjekt-Datensätze miteinander, zum Beispiel Konten mit ihren übergeordneten Konten. Legen Sie die Beziehung in Braze an, bevor Sie sie synchronisieren.
| Spalte | Erforderlich | Beschreibung |
|---|---|---|
OBJECT_ID |
Ja | Der Datensatz, von dem die Beziehung ausgeht. |
RELATED_OBJECT_ID |
Ja | Der Datensatz, auf den die Beziehung verweist. |
PAYLOAD |
Nein | Ein JSON-String mit den Feldern und Werten der Beziehung selbst. |
DELETED |
Nein | Bei true wird die Beziehung zwischen den beiden Datensätzen entfernt. |
JSON-Beispiel
{"object_id":"acct-001","related_object_id":"acct-010","payload":"{\"tier\":\"parent\"}"}
{"object_id":"acct-001","related_object_id":"acct-011","payload":"{\"tier\":\"parent\"}"}
{"object_id":"acct-002","related_object_id":"acct-020","deleted":true}
Canvas-Trigger ermöglichen Zero-Copy-Personalisierung. Informationen zur Einrichtung des Ziel-Canvas und zu wichtigen Hinweisen finden Sie unter Zero-Copy-Personalisierung.
| Feld | Erforderlich | Beschreibung |
|---|---|---|
EXTERNAL_ID |
Ja, entweder external_id oder alias_name und alias_label |
Identifiziert die Nutzer:in, die Sie aktualisieren möchten. Dieser Wert sollte mit dem in Braze verwendeten external_id-Wert übereinstimmen. |
ALIAS_NAME und ALIAS_LABEL |
Ja, entweder external_id oder alias_name und alias_label |
Diese beiden Spalten erstellen ein Nutzer-Alias-Objekt. alias_name sollte ein eindeutiger Bezeichner sein, und alias_label gibt den Typ des Alias an. Nutzer:innen können mehrere Aliase mit unterschiedlichen Labels haben, aber nur einen alias_name pro alias_label. |
PROPERTIES |
Ja | JSON-String mit Feldern, die in Ihrem Canvas als Personalisierungseigenschaften verfügbar sein sollen. Dieser sollte nutzerspezifische Informationen enthalten. |
Wählen Sie zum Einstieg beim Erstellen einer neuen Synchronisierung den Datentyp Canvas Triggers aus.
So löschen Sie Nutzerprofile in Braze mithilfe von Dateien in Ihrem Quell-Bucket:
- Erstellen Sie eine neue Cloud Data Ingestion-Synchronisierung mit derselben Einrichtung wie bei anderen Synchronisierungen.
- Setzen Sie beim Konfigurieren der Synchronisierung in Braze Data Type auf Delete Users.
- Laden Sie Dateien in Ihren Quell-Bucket hoch, die ausschließlich Nutzer-Bezeichner-Spalten enthalten. Fügen Sie keine Spalte
PAYLOADhinzu – die Synchronisierung schlägt fehl, wenn ein Payload vorhanden ist, um versehentliche Löschungen zu vermeiden.
Jede Zeile in der Datei muss genau eine Nutzer:in über einen der folgenden Bezeichner identifizieren:
| Bezeichner | Beschreibung |
|---|---|
EXTERNAL_ID |
Entspricht der in Braze verwendeten external_id. |
ALIAS_NAME und ALIAS_LABEL |
Beide Spalten zusammen identifizieren die Nutzer:in über den Alias. |
BRAZE_ID |
Von Braze generierte Nutzer-ID (nur für bestehende Nutzer:innen). |
JSON-Beispiel
{"external_id":"user-to-delete-001"}
{"external_id":"user-to-delete-002"}
{"braze_id":"braze-id-from-profile"}
CSV-Beispiel
external_id
user-to-delete-001
user-to-delete-002
Wenn die Synchronisierung ausgeführt wird, verarbeitet Braze neue Dateien im Bucket und löscht die entsprechenden Nutzerprofile.
Das Löschen von Nutzer:innen ist dauerhaft und kann nicht rückgängig gemacht werden. Nehmen Sie nur Nutzer:innen auf, die Sie tatsächlich entfernen möchten. Weitere Details finden Sie unter Nutzer:innen mit Cloud Data Ingestion löschen.
Katalogartikel löschen
So entfernen Sie Artikel aus einem Katalog mithilfe von Dateispeicher:
- Verwenden Sie dieselbe Synchronisierung, die Sie zum Synchronisieren von Katalogdaten nutzen (Datentyp Kataloge).
- Fügen Sie Ihren CSV- oder JSON-Dateien eine optionale Spalte
deleted(oderDELETED) hinzu. - Setzen Sie
deletedfür jeden Katalogartikel, den Sie in Braze aus dem Katalog entfernen möchten, auftrue.
Jede Zeile benötigt weiterhin ID und PAYLOAD. Bei Zeilen, die zum Löschen markiert sind, kann der Payload minimal sein, da Braze den Artikel anhand der ID entfernt.
Wenn die Synchronisierung ausgeführt wird, führen Zeilen mit deleted: true dazu, dass der entsprechende Katalogartikel in Braze gelöscht wird. Weitere Informationen zum vollständigen Verhalten beim Synchronisieren und Löschen von Katalogen finden Sie unter Katalogdaten synchronisieren und löschen.
Wissenswertes
- Dateien, die dem Quell-Bucket oder -Container hinzugefügt werden, sollten 512 MB nicht überschreiten. Diese Grenze gilt für Amazon S3, Google Cloud Storage und Azure Blob Storage. Dateien, die größer als 512 MB sind, führen zu einem Fehler und werden nicht mit Braze synchronisiert. Azure Blob Storage selbst erlaubt deutlich größere Dateien, CDI wendet jedoch für alle Dateispeicherquellen dieselbe Grenze von 512 MB an.
- Es gibt zwar keine zusätzliche Begrenzung der Anzahl der Zeilen pro Datei, Braze empfiehlt jedoch, kleinere Dateien zu verwenden, damit Ihre Synchronisierungen schneller laufen. Beispielsweise dauert die Aufnahme einer 500 MB großen Datei erheblich länger als die von fünf separaten 100 MB großen Dateien.
- Es gibt keine zusätzliche Begrenzung der Anzahl der Dateien, die in einem bestimmten Zeitraum hochgeladen werden.
- Eine Reihenfolge wird weder innerhalb von Dateien noch zwischen Dateien unterstützt. Braze empfiehlt, Updates regelmäßig in Batches zu bündeln, wenn Sie mögliche Race-Conditions überwachen.
- CDI verarbeitet nur Dateien, die nach dem Erstellen der Synchronisierung hinzugefügt werden. Sie können vorhandene Dateien verwenden, um zu prüfen, ob Braze auf Ihren Bucket zugreifen und Dateien für die Aufnahme erkennen kann. Diese Dateien werden jedoch nicht mit Braze synchronisiert. Damit CDI sie verarbeitet, laden Sie alle vorhandenen Dateien, die synchronisiert werden sollen, erneut in den Quell-Bucket hoch.
Fehlerbehebung
Hochladen und Verarbeiten von Dateien
CDI verarbeitet nur Dateien, die nach dem Erstellen der Synchronisierung hochgeladen wurden. Jeder neue Blob triggert ein Blob Created-Event an Ihre Warteschlange. Um Dateien aufzunehmen, die bereits im Container vorhanden sind, laden Sie sie erneut hoch.
Umgang mit unerwarteten Dateifehlern
Wenn Dateien nicht aufgenommen werden, überprüfen Sie Folgendes:
- Das Event-Abo ist im Speicherkonto vorhanden und auf Blob Created gefiltert.
- Das Event-Abo verwendet Event Grid Schema. CDI kann Events, die in einem anderen Schema zugestellt werden, nicht lesen.
- Der Endpunkt des Event-Abos verweist auf die in der Synchronisierung konfigurierte Warteschlange und nicht auf eine andere Warteschlange.
- Der Braze-Dienstprinzipal verfügt im Speicherkonto über die Rollen Storage Blob Data Reader, Storage Queue Data Reader und Storage Queue Data Message Processor.
- Das Client-Geheimnis des Dienstprinzipals ist nicht abgelaufen. Azure erzwingt einen Ablauf für Client-Geheimnisse, und ein abgelaufenes Geheimnis stoppt die Synchronisierung.
Weitere Informationen finden Sie unter Azure Blob Storage als Event Grid-Quelle in der Microsoft-Dokumentation.
Fehler „Incorrect Integration Object“
Dieser Fehler tritt auf, wenn zwei oder mehr Workspaces Integrationen haben, die auf denselben Cloud-Speicher-Bucket oder -Ordner verweisen. Jeder Cloud-Speicherort kann jeweils nur von einer Integration verwendet werden. Schritte zur Lösung finden Sie in den FAQ.
Verwandte Seiten
- Tabellen-Setup für erforderliche Spalten und die Formatierung von Payloads
- Best Practices für die Planung von Synchronisierungen und eine effiziente Nutzung von Datenpunkten
- Synchronisierungsprotokolle und Beobachtbarkeit für das Monitoring von Synchronisierungsläufen
- FAQ für häufige Fragen zu allen Quellen