 Reguläre Ausdrücke
Ein regulärer Ausdruck, allgemein als Regex bekannt, ist eine Zeichenfolge, die ein Suchmuster definiert. Reguläre Ausdrücke ermöglichen es Ihnen, Textgruppierungen zu validieren und Such- und Ersetzungsaktionen durchzuführen. Bei Braze nutzen wir reguläre Ausdrücke, um Ihnen eine flexiblere Lösung für den Zeichenkettenabgleich bei Ihrer Segmentierung und Campaign-Filterung für Ihre Zielgruppe zu bieten.
Diese Seite behandelt reguläre Ausdrücke (Regex), wie Sie diese verwenden können, häufig gestellte Fragen und bietet einen Regex-Debugger zum Testen regulärer Ausdrücke.
Im verlinkten Braze-Lernkurs zeigen wir Ihnen, wie reguläre Ausdrücke auf Regex101 verwendet und getestet werden können. Wir bieten außerdem einen internen Regex-Tester, eine hilfreiche Referenzseite, Beispieldaten, auf die im Regex-Braze-Lernvideo verwiesen wird, sowie einige häufig gestellte Fragen.
Ressourcen
- Grundlagen regulärer Ausdrücke Braze-Lernkurs
- Regex-Spickzettel
- Beispieldaten-RTF
Regex-Debugger
Dieses Tool dient nur als Referenz und garantiert nicht, dass der reguläre Ausdruck zu 100 % mit der Braze-Plattform übereinstimmt. Reguläre Ausdrücke in Braze für Segmentierung und Filter fügen automatisch den /gi-Modifikator hinzu. Der gi-Modifikator wird verwendet, um eine Suche ohne Berücksichtigung der Groß-/Kleinschreibung nach allen Vorkommen eines regulären Ausdrucks in einem String durchzuführen.
Reguläre Ausdrücke für Eigenschaften von angepassten Event-Triggern und Trigger-Filter verwenden den /g-Modifikator (Groß-/Kleinschreibung wird berücksichtigt, siehe g-Modifikator) und verwenden nicht den /i-Modifikator. Für die Nichtberücksichtigung der Groß-/Kleinschreibung bei Eigenschaften von angepassten Event-Triggern und Trigger-Filtern verwenden Sie stattdessen (?i). Zum Beispiel erfasst Matches regex (?i)STOP(?-i) jede Verwendung von „STOP“ in beliebiger Schreibweise (wie „stop“, „please stop“ und „never stop sending me messages“).
Wert(e) prüfen:
Übereinstimmende Ergebnisse:
Häufig gestellte Fragen
Schließt der Filter does not match regex leere Werte ein?
Nein. Wenn der Wert leer ist, werden Nutzer:innen nicht in den Filter does not match regex einbezogen.
Wie kann ich mehrere exakte Werte (ODER-Logik) für ein angepasstes String-Attribut abgleichen?
Verwenden Sie Alternation mit Start- und Endankern, damit jeder Wert exakt übereinstimmt und keine Teilübereinstimmungen erfasst werden. Um zum Beispiel exakt gold, silver oder bronze abzugleichen:
(^gold$)|(^silver$)|(^bronze$)
Wie filtere ich bei der Segmentierung nach Posteingangs-spezifischen E-Mail-Adressen?
Verwenden Sie den E-Mail-Adress-Filter und setzen Sie ihn auf matches regex. Verwenden Sie dann den regulären Ausdruck für E-Mail-Adressen:
[a-zA-Z0-9.+_-]+@[a-zA-Z0-9.-]+\.[a-zA-Z.-]+
Dieser Regex lässt sich in die folgenden drei Teile aufgliedern:
[a-zA-Z0-9.+_-]+ist der Anfang der E-Mail-Adresse vor dem At-Zeichen@. Also der „Name“ in „[email protected]“.[a-zA-Z0-9.-]+ist der erste Teil der Domain. Also „example“ in „[email protected]“.[a-zA-Z.-]+ist der letzte Teil der Domain. Also „com“ in „[email protected]“.
Wie filtere ich nach E-Mail-Adressen, die zu einer bestimmten Domain gehören?
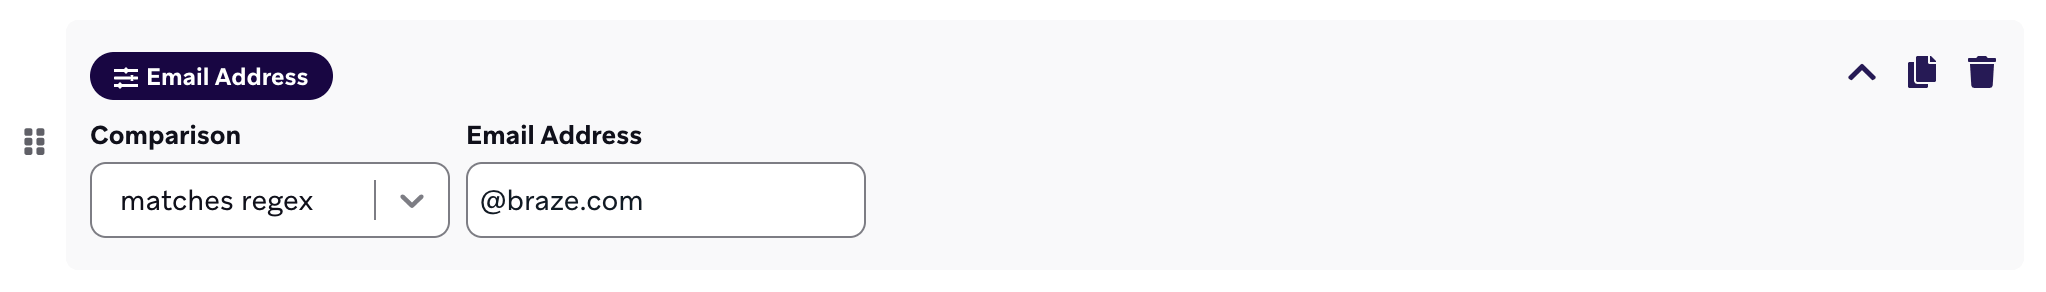
Angenommen, Sie möchten nach E-Mails filtern, die auf „@braze.com“ enden. Verwenden Sie den E-Mail-Adress-Filter, setzen Sie ihn auf matches regex und geben Sie „@braze.com“ in das Regex-Feld ein. Das Gleiche gilt für jede andere E-Mail-Domain.
Wie kann ich Zahlenstrings nach Werten ≥ x oder ≤ x filtern?
Wenn Sie nach Werten suchen, die größer oder gleich (≥) x sind, verwenden Sie den folgenden Regex:
^([x-y]|\d{z,})$
Dabei ist x-y der Zahlenbereich (0–9) der ersten Ziffer und z die Anzahl der Ziffern von x plus eins. Für Werte größer oder gleich 50 wäre der Regex demnach ^([5-9][0-9]|\d{3,})$.
Wenn Sie nach Werten suchen, die kleiner oder gleich (≤) x sind, verwenden Sie den folgenden Regex:
^([x-y]|[a-b])$
Dabei ist x-y der Zahlenbereich (0–9) der ersten Ziffer und a-b der untere Bereich von x. Für Werte kleiner oder gleich 50 wäre der Regex demnach ^([5-9][0-9]|[0-4][0-9])$.
Wie filtere ich angepasste Attribute, die mit einem bestimmten String beginnen?
Verwenden Sie das Caret-Symbol (^), um anzugeben, womit der String beginnt, und geben Sie dann den Namen des angepassten Attributs ein, das Sie angeben möchten.
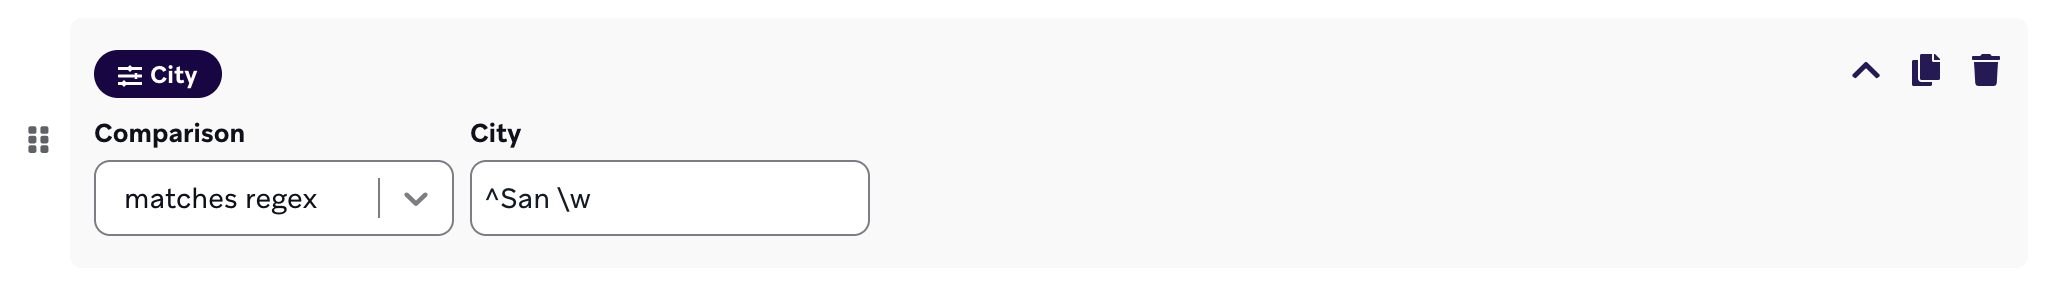
Wenn Sie beispielsweise Nutzer:innen ansprechen möchten, die in Städten leben, die mit „San“ beginnen, wäre Ihr Regex ^San \w. Mit diesem Regex würden Sie erfolgreich Nutzer:innen aus Städten wie San Francisco, San Diego, San Jose usw. ansprechen.
Wie filtere ich nach bestimmten Telefonnummern?
Bevor Sie Regex zum Filtern von Telefonnummern verwenden, beachten Sie, dass Telefonnummern, die für Nutzerprofile hinterlegt sind, im E.164-Format vorliegen müssen, wie unter Nutzer-Telefonnummern angegeben.
Wenn Sie nach US-Telefonnummern suchen, verwenden Sie das Regex-Format 1?\d\d\d\d\d\d\d\d\d\d, wobei jede Wiederholung von \d eine Ziffer ist, die Sie angeben möchten. Die ersten drei Ziffern sind die Vorwahl.
Ebenso ist das Format für britische Telefonnummern ^\+4\d\d\d\d\d\d\d\d\d\d\d. Für jedes andere Land wird die jeweilige Landesvorwahl gefolgt von der erforderlichen Anzahl an \d-Wiederholungen für jede verbleibende Ziffer verwendet. Im Fall von Litauen mit der Landesvorwahl „3“ wäre der Regex also ^\+3\d\d\d\d\d\d\d\d\d\d.
Wenn Ihre britischen Mobilnummern ohne führendes + im gängigen Format gespeichert sind und mit 447 beginnen (zum Beispiel 447123456789), können Sie sie mit folgendem Ausdruck abgleichen:
^447\d{9}$
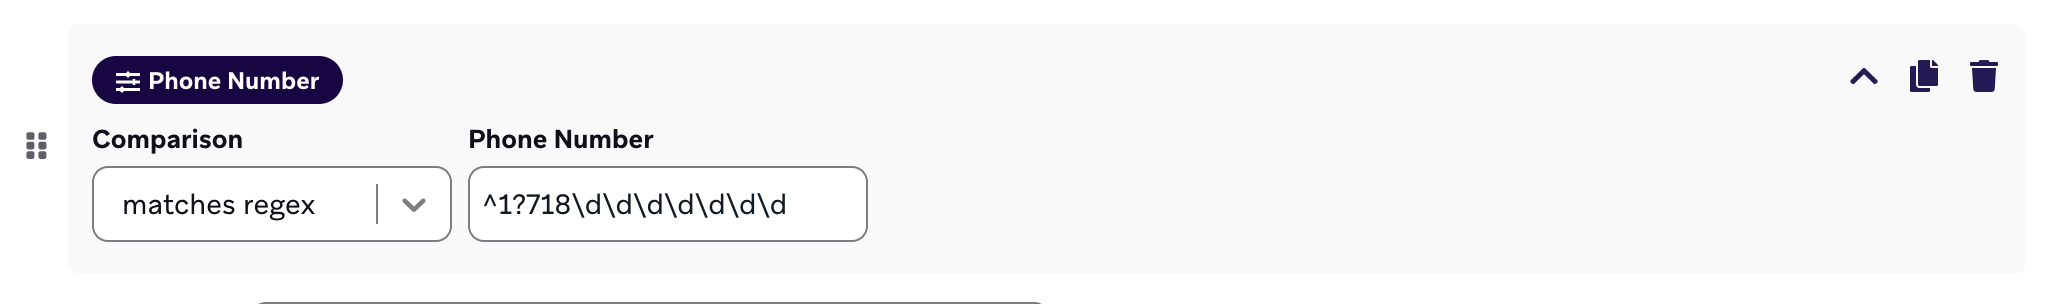
Angenommen, Sie möchten Nutzer:innen nach Telefonnummer für eine bestimmte Vorwahl, „718“, filtern. Verwenden Sie den Telefonnummer-Filter, setzen Sie ihn auf matches regex und geben Sie den folgenden Regex ein:
^1?718\d\d\d\d\d\d\d
Wie unterscheidet sich der Regex-Abgleich zwischen Segmenten und benutzerdefinierten Event-Trigger-Eigenschaften?
Segment-Filter wenden automatisch einen Abgleich ohne Berücksichtigung der Groß-/Kleinschreibung an (entspricht dem /gi-Modifikator). Benutzerdefinierte Event-Trigger-Eigenschaften und Trigger-Filter verwenden einen Abgleich mit Berücksichtigung der Groß-/Kleinschreibung (entspricht nur /g).
Wenn Sie bei einer Trigger-Eigenschaft einen Abgleich ohne Berücksichtigung der Groß-/Kleinschreibung benötigen, verwenden Sie Inline-Flags in Ihrem Muster – zum Beispiel (?i)STOP(?-i), um stop, STOP oder Stop abzugleichen.
Weitere Beispiele finden Sie im Hinweis im Abschnitt Regex-Debugger.