Data Warehouse-Speicherintegrationen
Auf dieser Seite erfahren Sie, wie Sie Braze Cloud-Datenaufnahme (CDI) verwenden, um relevante Daten mit Ihrer Snowflake-, Redshift-, BigQuery- und Databricks-Integration zu synchronisieren.
Data-Warehouse-Integrationen einrichten
Für Integrationen mit Cloud Data Ingestion ist eine gewisse Einrichtung sowohl auf der Seite von Braze als auch in Ihrer Data-Warehouse-Instanz erforderlich. Führen Sie die folgenden Schritte aus, um die Integration einzurichten:
- Richten Sie in Ihrer Snowflake-Instanz die Tabellen oder Ansichten ein, die Sie mit Braze synchronisieren möchten.
- Erstellen Sie eine Rolle, ein Warehouse und eine Nutzer:in, bei der sich Braze über Workload Identity Federation oder ein RSA-Schlüsselpaar authentifiziert.
- Erstellen Sie im Braze-Dashboard eine neue Snowflake-Quelle. Bei einem Schlüsselpaar fügen Sie den von Braze bereitgestellten Public Key der Snowflake-Nutzer:in hinzu. Bei Workload Identity Federation führen Sie die Anweisung aus dem Formular für Zugangsdaten in einem Snowflake-Worksheet aus.
- Erstellen Sie im Braze-Dashboard eine Synchronisierung, testen Sie die Integration und starten Sie die Synchronisierung.
Der Snowflake-Schnellstartleitfaden enthält Beispielcode und führt Sie durch die erforderlichen Schritte, um mit Snowflake Streams und CDI eine automatisierte Pipeline für die Synchronisierung von Daten mit Braze zu erstellen.
- Stellen Sie sicher, dass Braze Zugriff auf die Redshift-Tabellen hat, die Sie synchronisieren möchten. Braze verbindet sich über das Internet mit Redshift.
- Richten Sie in Ihrer Redshift-Instanz die Tabellen oder Ansichten ein, die Sie mit Braze synchronisieren möchten.
- Erstellen Sie im Braze-Dashboard eine neue Quelle und Synchronisierung.
- Testen Sie die Integration und starten Sie die Synchronisierung.
Wie viele Zeilen pro Synchronisierung verarbeitet werden, hängt von der Performance Ihres Warehouse, der Netzwerklatenz und davon ab, wie viele neue Daten der Synchronisierungsabfrage entsprechen. Im Synchronisierungsverlauf der Integration im Dashboard sehen Sie die Dauer und die Zeilenanzahl der letzten Durchläufe.
- Erstellen Sie ein Dienstkonto, auf das Braze über Workload Identity Federation oder einen Dienstkontoschlüssel zugreift, und gewähren Sie Zugriff auf die BigQuery-Projekte und -Datensätze, die die zu synchronisierenden Daten enthalten.
- Richten Sie in Ihrem BigQuery-Konto die Tabellen oder Ansichten ein, die Sie mit Braze synchronisieren möchten.
- Erstellen Sie im Braze-Dashboard eine neue Quelle und Synchronisierung.
- Testen Sie die Integration und starten Sie die Synchronisierung.
- Erstellen Sie einen Service Principal für die OAuth-Machine-to-Machine-Authentifizierung (M2M) oder ein persönliches Zugriffstoken, und gewähren Sie Zugriff auf die Databricks-Kataloge und -Schemata, die die zu synchronisierenden Daten enthalten.
- Richten Sie in Ihrem Databricks-Konto die Tabellen oder Ansichten ein, die Sie mit Braze synchronisieren möchten.
- Erstellen Sie im Braze-Dashboard eine neue Quelle und Synchronisierung.
- Testen Sie die Integration und starten Sie die Synchronisierung.
Wenn Braze sich mit Classic- und Pro-SQL-Instanzen verbindet, kann eine Aufwärmzeit von zwei bis fünf Minuten anfallen. Das kann zu Verzögerungen bei der Einrichtung und beim Testen der Verbindung sowie zu Beginn geplanter Synchronisierungen führen. Eine serverlose SQL-Instanz minimiert die Aufwärmzeit und verbessert den Abfragedurchsatz, kann aber etwas höhere Integrationskosten verursachen.
- Erstellen Sie einen Service Principal und gewähren Sie Zugriff auf die Fabric-APIs.
- Richten Sie einen freigegebenen Workspace ein und gewähren Sie dem Service Principal Zugriff darauf.
- Richten Sie im freigegebenen Fabric-Workspace die Tabellen oder Ansichten ein, die Sie mit Braze synchronisieren möchten.
- Erstellen Sie im Braze-Dashboard eine neue Quelle und Synchronisierung.
- Testen Sie die Integration und starten Sie die Synchronisierung.
Schritt 1: Tabellen oder Ansichten einrichten
Mit den Schritten in diesem Abschnitt erstellen Sie eine Tabelle mit einer PAYLOAD-Spalte. Wenn Sie im Schritt Datendefinition Spalten mit Visuell zuordnen oder mit SQL eine Abfrage schreiben möchten, können Sie stattdessen eine vorhandene Tabelle oder Ansicht verwenden. Überspringen Sie in diesem Fall den Schritt zur Tabellenerstellung für Ihr Warehouse und gewähren Sie Braze Lesezugriff auf die Tabellen oder Ansichten, die Sie synchronisieren möchten. Einen Vergleich der Optionen finden Sie unter Eine Option für die Datendefinition auswählen.
Wenn Sie eine PAYLOAD-Spalte verwenden, kann Ihre Quelltabelle oder -ansicht auch Spalten enthalten, die in den Tabs im folgenden Abschnitt für Ihr Warehouse nicht aufgeführt sind (zum Beispiel für Auditing oder Hashing). Braze liest nur die in diesen Tabs beschriebenen Spalten. Andere Spalten werden bei Synchronisierungen mit Cloud Data Ingestion nicht verwendet.
Schritt 1.1: Tabelle einrichten
CREATE DATABASE BRAZE_CLOUD_PRODUCTION;
CREATE SCHEMA BRAZE_CLOUD_PRODUCTION.INGESTION;
CREATE OR REPLACE TABLE BRAZE_CLOUD_PRODUCTION.INGESTION.USERS_ATTRIBUTES_SYNC (
UPDATED_AT TIMESTAMP_NTZ(9) NOT NULL DEFAULT SYSDATE(),
--at least one of external_id, alias_name and alias_label, email, phone, or braze_id is required
EXTERNAL_ID VARCHAR(16777216),
--if using user alias, both alias_name and alias_label are required
ALIAS_LABEL VARCHAR(16777216),
ALIAS_NAME VARCHAR(16777216),
--braze_id can only be used to update existing users created through the Braze SDK
BRAZE_ID VARCHAR(16777216),
--If you include both email and phone, email is used as the primary identifier
EMAIL VARCHAR(16777216),
PHONE VARCHAR(16777216),
PAYLOAD VARCHAR(16777216) NOT NULL
);
Sie können Datenbank, Schema und Tabelle beliebig benennen, die Spaltennamen sollten jedoch der vorstehenden Definition entsprechen.
UPDATED_AT- Der Zeitpunkt, zu dem diese Zeile in der Tabelle aktualisiert oder hinzugefügt wurde. Braze synchronisiert Zeilen, derenUPDATED_ATnach dem zuletzt synchronisierten Wert liegt. Zeilen mit genau dem Grenz-Zeitstempel werden möglicherweise erneut synchronisiert, wenn neue Zeilen denselben Zeitstempel haben.- Spalten für Nutzer-Bezeichner - Ihre Tabelle kann eine oder mehrere Spalten mit Nutzer-Bezeichnern enthalten. Jede Zeile sollte nur einen Bezeichner enthalten (entweder
external_id, die Kombination ausalias_nameundalias_label,braze_id,emailoderphone). Eine Quelltabelle kann Spalten für einen, zwei, drei, vier oder alle fünf Bezeichnertypen enthalten.EXTERNAL_ID- Damit wird die Nutzer:in identifiziert, die Sie aktualisieren möchten. Dieser Wert sollte mit dem in Braze verwendetenexternal_id-Wert übereinstimmen.ALIAS_NAMEundALIAS_LABEL- Diese beiden Spalten erstellen ein Nutzer-Alias-Objekt.alias_namesollte ein eindeutiger Bezeichner sein, undalias_labelgibt den Typ des Alias an. Nutzer:innen können mehrere Aliase mit unterschiedlichen Labels haben, aber nur einenalias_nameproalias_label.BRAZE_ID- Der Braze-Nutzer-Bezeichner. Er wird vom Braze SDK generiert, und über Cloud Data Ingestion können keine neuen Nutzer:innen mit einer Braze-ID erstellt werden. Um neue Nutzer:innen zu erstellen, geben Sie eine externe Nutzer-ID oder einen Nutzer-Alias an.EMAIL- Die E-Mail-Adresse der Nutzer:in. Wenn mehrere Profile mit derselben E-Mail-Adresse existieren, wird das zuletzt aktualisierte Profil bei Updates priorisiert. Wenn Sie sowohl E-Mail-Adresse als auch Telefonnummer angeben, wird die E-Mail-Adresse als primärer Bezeichner verwendet.PHONE- Die Telefonnummer der Nutzer:in. Wenn mehrere Profile mit derselben Telefonnummer existieren, wird das zuletzt aktualisierte Profil bei Updates priorisiert.
PAYLOAD- Dies ist ein JSON-String mit den Feldern, die Sie mit der Nutzer:in in Braze synchronisieren möchten.
Schritt 1.2: Rolle und Datenbankberechtigungen einrichten
CREATE ROLE BRAZE_INGESTION_ROLE;
GRANT USAGE ON DATABASE BRAZE_CLOUD_PRODUCTION TO ROLE BRAZE_INGESTION_ROLE;
GRANT USAGE ON SCHEMA BRAZE_CLOUD_PRODUCTION.INGESTION TO ROLE BRAZE_INGESTION_ROLE;
GRANT SELECT ON TABLE BRAZE_CLOUD_PRODUCTION.INGESTION.USERS_ATTRIBUTES_SYNC TO ROLE BRAZE_INGESTION_ROLE;
Passen Sie die Namen bei Bedarf an, die Berechtigungen sollten jedoch dem vorstehenden Beispiel entsprechen.
Schritt 1.3: Warehouse einrichten und der Braze-Rolle Zugriff gewähren
CREATE WAREHOUSE BRAZE_INGESTION_WAREHOUSE;
GRANT USAGE ON WAREHOUSE BRAZE_INGESTION_WAREHOUSE TO ROLE BRAZE_INGESTION_ROLE;
Für das Warehouse muss das Flag auto-resume aktiviert sein. Ist das nicht der Fall, gewähren Sie Braze zusätzliche OPERATE-Berechtigungen für das Warehouse, damit Braze es beim Ausführen der Abfrage einschalten kann.
Schritt 1.4: Nutzer:in einrichten
Braze authentifiziert sich bei Snowflake mit einer der folgenden Methoden:
- Workload Identity Federation: Braze verbindet sich als Nutzer:in vom Typ
TYPE = SERVICE, die an die AWS-Identität von Braze für Snowflake gebunden ist. Die Nutzer:in hat weder ein Passwort noch einen RSA-Schlüssel. - Schlüsselpaar: Braze verbindet sich mit einem RSA-Schlüsselpaar. Sie fügen den von Braze generierten Public Key der Snowflake-Nutzer:in hinzu.
Bestehende Zugangsdaten mit RSA-Schlüsselpaar funktionieren weiterhin, und Sie müssen sie nicht migrieren. Wählen Sie eine der beiden Methoden.
Erstellen Sie die Rolle, das Warehouse und die Datenbankberechtigungen aus Schritt 1.2 und Schritt 1.3. Wenn Ihr Snowflake-Konto eine Netzwerkrichtlinie verwendet, lassen Sie die IP-Adressen von Braze wie in Schritt 1.5 beschrieben zu.
Erstellen Sie die Dienst-Nutzer:in über das Snowflake-Formular für Zugangsdaten und führen Sie die Anweisung in einem Snowflake-Worksheet aus. Was die Anweisung bewirkt und wo Sie sie ausführen, erfahren Sie unter Snowflake für Workload Identity Federation konfigurieren.
CREATE USER BRAZE_INGESTION_USER;
GRANT ROLE BRAZE_INGESTION_ROLE TO USER BRAZE_INGESTION_USER;
Teilen Sie nach diesem Schritt die Verbindungsinformationen mit Braze und fügen Sie den Public Key der Nutzer:in hinzu.
Wenn Sie verschiedene Workspaces mit demselben Snowflake-Konto verbinden, müssen Sie für jeden Braze-Workspace, in dem Sie eine Integration erstellen, eine eigene Nutzer:in anlegen. Innerhalb eines Workspace können Sie dieselbe Nutzer:in für mehrere Integrationen wiederverwenden. Die Erstellung einer Integration schlägt jedoch fehl, wenn eine Nutzer:in desselben Snowflake-Kontos in mehreren Workspaces verwendet wird.
Schritt 1.5: Braze-IPs in der Snowflake-Netzwerkrichtlinie zulassen (optional)
Je nach Konfiguration Ihres Snowflake-Kontos müssen Sie die folgenden IP-Adressen möglicherweise in Ihrer Snowflake-Netzwerkrichtlinie zulassen. Weitere Informationen dazu finden Sie in der Snowflake-Dokumentation zum Ändern einer Netzwerkrichtlinie.
Für die Instanzen US-01, US-02, US-03, US-04, US-05, US-06, US-07 sind dies die relevanten IP-Adressen:
23.21.118.19134.206.23.17350.16.249.952.4.160.21454.87.8.3454.156.35.25152.54.89.23818.205.178.15
Für die Instanz US-08 sind dies die relevanten IP-Adressen:
52.151.246.5152.170.163.18240.76.166.15740.76.166.17040.76.166.16740.76.166.16140.76.166.15640.76.166.16640.76.166.16040.88.51.7452.154.67.1740.76.166.8040.76.166.8440.76.166.8540.76.166.8140.76.166.7140.76.166.14440.76.166.145
Für die Instanz US-10 sind dies die relevanten IP-Adressen:
100.25.232.16435.168.86.17952.7.44.1173.92.153.1835.172.3.12950.19.162.19
Für die Instanzen EU-01 und EU-02 sind dies die relevanten IP-Adressen:
52.58.142.24252.29.193.12135.158.29.22818.157.135.973.123.166.463.64.27.363.65.88.253.68.144.1883.70.107.88
Für die Instanz AU-01 sind dies die relevanten IP-Adressen:
13.210.1.14513.211.70.15913.238.45.5452.65.73.16754.153.242.23954.206.45.213
Für die Instanz ID-01 sind dies die relevanten IP-Adressen:
108.136.157.246108.137.30.20716.78.128.7116.78.14.13416.78.162.20843.218.73.35
Für die Instanz JP-01 sind dies die relevanten IP-Adressen:
13.159.155.21254.199.221.24113.192.23.1654.250.120.13918.181.114.2323.114.38.100
Für die Instanz KR-01 sind dies die relevanten IP-Adressen:
43.200.215.452.79.67.17552.79.113.603.34.212.9254.116.134.2313.37.197.225
Schritt 1.1: Tabelle einrichten
Richten Sie optional eine neue Datenbank und ein neues Schema für Ihre Quelltabelle ein.
CREATE DATABASE BRAZE_CLOUD_PRODUCTION;
CREATE SCHEMA BRAZE_CLOUD_PRODUCTION.INGESTION;
Erstellen Sie eine Tabelle (oder Ansicht) für Ihre CDI-Integration.
CREATE TABLE BRAZE_CLOUD_PRODUCTION.INGESTION.USERS_ATTRIBUTES_SYNC (
updated_at timestamptz default sysdate,
--at least one of external_id, alias_name and alias_label, or braze_id is required
external_id varchar,
--if using user alias, both alias_name and alias_label are required
alias_label varchar,
alias_name varchar,
--braze_id can only be used to update existing users created through the Braze SDK
braze_id varchar,
--If you include both email and phone, email is used as the primary identifier
email varchar,
phone varchar,
payload varchar(max)
)
Sie können Datenbank, Schema und Tabelle beliebig benennen, die Spaltennamen sollten jedoch der vorstehenden Definition entsprechen.
UPDATED_AT- Der Zeitpunkt, zu dem diese Zeile in der Tabelle aktualisiert oder hinzugefügt wurde. Braze synchronisiert Zeilen, derenUPDATED_ATnach dem zuletzt synchronisierten Wert liegt. Zeilen mit genau dem Grenz-Zeitstempel werden möglicherweise erneut synchronisiert, wenn neue Zeilen denselben Zeitstempel haben.- Spalten für Nutzer-Bezeichner - Ihre Tabelle kann eine oder mehrere Spalten mit Nutzer-Bezeichnern enthalten. Jede Zeile sollte nur einen Bezeichner enthalten (entweder
external_id, die Kombination ausalias_nameundalias_label,braze_id,emailoderphone). Eine Quelltabelle kann Spalten für einen, zwei, drei, vier oder alle fünf Bezeichnertypen enthalten.EXTERNAL_ID- Damit wird die Nutzer:in identifiziert, die Sie aktualisieren möchten. Dieser Wert sollte mit dem in Braze verwendetenexternal_id-Wert übereinstimmen.ALIAS_NAMEundALIAS_LABEL- Diese beiden Spalten erstellen ein Nutzer-Alias-Objekt.alias_namesollte ein eindeutiger Bezeichner sein, undalias_labelgibt den Typ des Alias an. Nutzer:innen können mehrere Aliase mit unterschiedlichen Labels haben, aber nur einenalias_nameproalias_label.BRAZE_ID- Der Braze-Nutzer-Bezeichner. Er wird vom Braze SDK generiert, und über Cloud Data Ingestion können keine neuen Nutzer:innen mit einer Braze-ID erstellt werden. Um neue Nutzer:innen zu erstellen, geben Sie eine externe Nutzer-ID oder einen Nutzer-Alias an.EMAIL- Die E-Mail-Adresse der Nutzer:in. Wenn mehrere Profile mit derselben E-Mail-Adresse existieren, wird das zuletzt aktualisierte Profil bei Updates priorisiert. Wenn Sie sowohl E-Mail-Adresse als auch Telefonnummer angeben, wird die E-Mail-Adresse als primärer Bezeichner verwendet.PHONE- Die Telefonnummer der Nutzer:in. Wenn mehrere Profile mit derselben Telefonnummer existieren, wird das zuletzt aktualisierte Profil bei Updates priorisiert.
PAYLOAD- Dies ist ein JSON-String mit den Feldern, die Sie mit der Nutzer:in in Braze synchronisieren möchten.
Schritt 1.2: Nutzer:in erstellen und Berechtigungen gewähren
CREATE USER braze_user PASSWORD '{password}';
GRANT USAGE ON SCHEMA BRAZE_CLOUD_PRODUCTION.INGESTION to braze_user;
GRANT SELECT ON TABLE USERS_ATTRIBUTES_SYNC TO braze_user;
Dies sind die mindestens erforderlichen Berechtigungen für diese Nutzer:in. Wenn Sie mehrere CDI-Integrationen erstellen, können Sie Berechtigungen für ein Schema gewähren oder sie über eine Gruppe verwalten.
Schritt 1.3: Zugriff für Braze-IPs zulassen
Wenn Sie eine Firewall oder andere Netzwerkrichtlinien verwenden, müssen Sie Braze Netzwerkzugriff auf Ihre Redshift-Instanz gewähren. Ein Beispiel für einen Redshift-URL-Endpunkt ist „example-cluster.ap-northeast-2.redshift.amazonaws.com“.
Einige wichtige Hinweise:
- Möglicherweise müssen Sie auch Ihre Sicherheitsgruppen anpassen, damit Braze auf Ihre Daten in Redshift zugreifen kann.
- Lassen Sie eingehenden Datenverkehr für die IPs in der Tabelle und auf dem Port, der für Abfragen Ihres Redshift-Clusters verwendet wird (standardmäßig 5439), ausdrücklich zu. Sie sollten Redshift-TCP-Verbindungen auf diesem Port auch dann ausdrücklich zulassen, wenn die Regeln für eingehenden Datenverkehr auf „allow all“ gesetzt sind.
- Der Endpunkt des Redshift-Clusters muss öffentlich zugänglich sein, damit Braze sich mit Ihrem Cluster verbinden kann.
- Wenn Ihr Redshift-Cluster nicht öffentlich zugänglich sein soll, können Sie eine VPC und eine EC2-Instanz einrichten, um über einen SSH-Tunnel auf die Redshift-Daten zuzugreifen. Weitere Informationen finden Sie im Beitrag im AWS Knowledge Center.
Lassen Sie den Zugriff von den folgenden IPs zu, die der Region Ihres Braze-Dashboards entsprechen.
Für die Instanzen US-01, US-02, US-03, US-04, US-05, US-06, US-07 sind dies die relevanten IP-Adressen:
23.21.118.19134.206.23.17350.16.249.952.4.160.21454.87.8.3454.156.35.25152.54.89.23818.205.178.15
Für die Instanz US-08 sind dies die relevanten IP-Adressen:
52.151.246.5152.170.163.18240.76.166.15740.76.166.17040.76.166.16740.76.166.16140.76.166.15640.76.166.16640.76.166.16040.88.51.7452.154.67.1740.76.166.8040.76.166.8440.76.166.8540.76.166.8140.76.166.7140.76.166.14440.76.166.145
Für die Instanz US-10 sind dies die relevanten IP-Adressen:
100.25.232.16435.168.86.17952.7.44.1173.92.153.1835.172.3.12950.19.162.19
Für die Instanzen EU-01 und EU-02 sind dies die relevanten IP-Adressen:
52.58.142.24252.29.193.12135.158.29.22818.157.135.973.123.166.463.64.27.363.65.88.253.68.144.1883.70.107.88
Für die Instanz AU-01 sind dies die relevanten IP-Adressen:
13.210.1.14513.211.70.15913.238.45.5452.65.73.16754.153.242.23954.206.45.213
Für die Instanz ID-01 sind dies die relevanten IP-Adressen:
108.136.157.246108.137.30.20716.78.128.7116.78.14.13416.78.162.20843.218.73.35
Für die Instanz JP-01 sind dies die relevanten IP-Adressen:
13.159.155.21254.199.221.24113.192.23.1654.250.120.13918.181.114.2323.114.38.100
Für die Instanz KR-01 sind dies die relevanten IP-Adressen:
43.200.215.452.79.67.17552.79.113.603.34.212.9254.116.134.2313.37.197.225
Schritt 1.1: Tabelle einrichten
Richten Sie optional ein neues Projekt oder einen neuen Datensatz für Ihre Quelltabelle ein.
CREATE SCHEMA BRAZE-CLOUD-PRODUCTION.INGESTION;
Erstellen Sie eine oder mehrere Tabellen für Ihre CDI-Integration mit den folgenden Feldern:
CREATE TABLE `BRAZE-CLOUD-PRODUCTION.INGESTION.USERS_ATTRIBUTES_SYNC`
(
updated_at TIMESTAMP DEFAULT current_timestamp,
--At least one of external_id, alias_name and alias_label, or braze_id is required
external_id STRING,
--If using user alias, both alias_name and alias_label are required
alias_name STRING,
alias_label STRING,
--braze_id can only be used to update existing users created through the Braze SDK
braze_id STRING,
--If you include both email and phone, email is used as the primary identifier
email STRING,
phone STRING,
payload JSON
);
| Feldname | Typ | Modus |
|---|---|---|
UPDATED_AT |
TIMESTAMP | REQUIRED |
PAYLOAD |
JSON | REQUIRED |
EXTERNAL_ID |
STRING | NULLABLE |
ALIAS_NAME |
STRING | NULLABLE |
ALIAS_LABEL |
STRING | NULLABLE |
BRAZE_ID |
STRING | NULLABLE |
EMAIL |
STRING | NULLABLE |
PHONE |
STRING | NULLABLE |
Sie können Projekt, Datensatz und Tabelle beliebig benennen, die Spaltennamen sollten jedoch der vorstehenden Definition entsprechen.
UPDATED_AT- Der Zeitpunkt, zu dem diese Zeile in der Tabelle aktualisiert oder hinzugefügt wurde. Braze synchronisiert Zeilen, derenUPDATED_ATnach dem zuletzt synchronisierten Wert liegt. Zeilen mit genau dem Grenz-Zeitstempel werden möglicherweise erneut synchronisiert, wenn neue Zeilen denselben Zeitstempel haben.- Spalten für Nutzer-Bezeichner - Ihre Tabelle kann eine oder mehrere Spalten mit Nutzer-Bezeichnern enthalten. Jede Zeile sollte nur einen Bezeichner enthalten (entweder
external_id, die Kombination ausalias_nameundalias_label,braze_id,emailoderphone). Eine Quelltabelle kann Spalten für einen, zwei, drei, vier oder alle fünf Bezeichnertypen enthalten.EXTERNAL_ID- Damit wird die Nutzer:in identifiziert, die Sie aktualisieren möchten. Dieser Wert sollte mit dem in Braze verwendetenexternal_id-Wert übereinstimmen.ALIAS_NAMEundALIAS_LABEL- Diese beiden Spalten erstellen ein Nutzer-Alias-Objekt.alias_namesollte ein eindeutiger Bezeichner sein, undalias_labelgibt den Typ des Alias an. Nutzer:innen können mehrere Aliase mit unterschiedlichen Labels haben, aber nur einenalias_nameproalias_label.BRAZE_ID- Der Braze-Nutzer-Bezeichner. Er wird vom Braze SDK generiert, und über Cloud Data Ingestion können keine neuen Nutzer:innen mit einer Braze-ID erstellt werden. Um neue Nutzer:innen zu erstellen, geben Sie eine externe Nutzer-ID oder einen Nutzer-Alias an.EMAIL- Die E-Mail-Adresse der Nutzer:in. Wenn mehrere Profile mit derselben E-Mail-Adresse existieren, wird das zuletzt aktualisierte Profil bei Updates priorisiert. Wenn Sie sowohl E-Mail-Adresse als auch Telefonnummer angeben, wird die E-Mail-Adresse als primärer Bezeichner verwendet.PHONE- Die Telefonnummer der Nutzer:in. Wenn mehrere Profile mit derselben Telefonnummer existieren, wird das zuletzt aktualisierte Profil bei Updates priorisiert.
PAYLOAD- Dies ist ein JSON-String mit den Feldern, die Sie mit der Nutzer:in in Braze synchronisieren möchten.
BigQuery-Partitionierung
CDI unterstützt Partitionen für BigQuery. Wenn Sie nach einer Funktion von UPDATED_AT partitionieren (zum Beispiel je nach Größe Ihres Datensatzes auf Tages-, Wochen- oder Stundenebene), kann BigQuery die zu durchsuchenden Daten reduzieren. Das verbessert Performance und Effizienz bei sehr großen Tabellen.
Partitionieren Sie nicht nach anderen Feldern. Testen Sie verschiedene Konfigurationen, um die beste Einrichtung für Ihre Daten zu finden.
Alle CDI-Abfragen filtern nach UPDATED_AT, dieses Verhalten kann sich jedoch ändern. Gestalten Sie Ihr Tabellenschema so, dass Abfragen diese Klausel nicht enthalten müssen.
Weitere Informationen finden Sie in der Dokumentation zur BigQuery-Partitionierung.
Schritt 1.2: Zugangsdaten für Braze erstellen
Erstellen Sie in GCP ein Dienstkonto, mit dem Braze sich verbinden und Daten aus Ihren Tabellen lesen kann. Das Dienstkonto sollte die folgenden Berechtigungen haben:
- BigQuery Connection User: Ermöglicht Braze, Verbindungen herzustellen.
- BigQuery User: Gewährt Braze Zugriff, um Abfragen auszuführen, Metadaten von Datensätzen zu lesen und Tabellen aufzulisten.
- BigQuery Data Viewer: Gewährt Braze Zugriff, um Datensätze und deren Inhalte anzuzeigen.
- BigQuery Job User: Gewährt Braze Zugriff, um Jobs auszuführen.
Braze kann mit einer der folgenden Authentifizierungsmethoden auf das Dienstkonto zugreifen:
- Workload Identity Federation: Braze nimmt mit einer kurzlebigen Identität die Identität des Dienstkontos an, sodass Sie keinen Schlüssel erstellen oder hochladen müssen.
- Dienstkontoschlüssel: Sie laden einen JSON-Schlüssel für das Dienstkonto in Braze hoch.
Bestehende Zugangsdaten mit Dienstkontoschlüssel funktionieren weiterhin, und Sie müssen sie nicht migrieren. Zugangsdaten für Workload Identity Federation können sowohl für BigQuery- als auch für Google-Cloud-Storage-Quellen verwendet werden.
Richten Sie einen Workload Identity Pool, einen Anbieter und das Dienstkonto ein, und binden Sie den Braze-Principal an das Dienstkonto. Die einzelnen Schritte finden Sie unter Google Cloud für Workload Identity Federation konfigurieren. Wenn Sie Workload Identity Federation bereits für eine Google-Cloud-Storage-Quelle eingerichtet haben, müssen Sie dies nicht wiederholen. Gewähren Sie dem bestehenden Dienstkonto die in diesem Schritt aufgeführten Berechtigungen.
Nachdem Sie das Dienstkonto erstellt und die Berechtigungen gewährt haben, generieren Sie einen JSON-Schlüssel. Weitere Informationen finden Sie unter Dienstkontoschlüssel erstellen und löschen. Laden Sie diesen Schlüssel in einem späteren Schritt im Braze-Dashboard hoch.
Schritt 1.3: Zugriff für Braze-IPs zulassen
Wenn Sie Netzwerkrichtlinien verwenden, müssen Sie Braze Netzwerkzugriff auf Ihre BigQuery-Instanz gewähren. Lassen Sie den Zugriff von den folgenden IPs zu, die der Region Ihres Braze-Dashboards entsprechen.
Für die Instanzen US-01, US-02, US-03, US-04, US-05, US-06, US-07 sind dies die relevanten IP-Adressen:
23.21.118.19134.206.23.17350.16.249.952.4.160.21454.87.8.3454.156.35.25152.54.89.23818.205.178.15
Für die Instanz US-08 sind dies die relevanten IP-Adressen:
52.151.246.5152.170.163.18240.76.166.15740.76.166.17040.76.166.16740.76.166.16140.76.166.15640.76.166.16640.76.166.16040.88.51.7452.154.67.1740.76.166.8040.76.166.8440.76.166.8540.76.166.8140.76.166.7140.76.166.14440.76.166.145
Für die Instanz US-10 sind dies die relevanten IP-Adressen:
100.25.232.16435.168.86.17952.7.44.1173.92.153.1835.172.3.12950.19.162.19
Für die Instanzen EU-01 und EU-02 sind dies die relevanten IP-Adressen:
52.58.142.24252.29.193.12135.158.29.22818.157.135.973.123.166.463.64.27.363.65.88.253.68.144.1883.70.107.88
Für die Instanz AU-01 sind dies die relevanten IP-Adressen:
13.210.1.14513.211.70.15913.238.45.5452.65.73.16754.153.242.23954.206.45.213
Für die Instanz ID-01 sind dies die relevanten IP-Adressen:
108.136.157.246108.137.30.20716.78.128.7116.78.14.13416.78.162.20843.218.73.35
Für die Instanz JP-01 sind dies die relevanten IP-Adressen:
13.159.155.21254.199.221.24113.192.23.1654.250.120.13918.181.114.2323.114.38.100
Für die Instanz KR-01 sind dies die relevanten IP-Adressen:
43.200.215.452.79.67.17552.79.113.603.34.212.9254.116.134.2313.37.197.225
Schritt 1.1: Tabelle einrichten
Richten Sie optional einen neuen Katalog oder ein neues Schema für Ihre Quelltabelle ein.
CREATE SCHEMA BRAZE-CLOUD-PRODUCTION.INGESTION;
Erstellen Sie eine oder mehrere Tabellen für Ihre CDI-Integration mit den folgenden Feldern:
CREATE TABLE `BRAZE-CLOUD-PRODUCTION.INGESTION.USERS_ATTRIBUTES_SYNC`
(
updated_at TIMESTAMP DEFAULT current_timestamp(),
--At least one of external_id, alias_name and alias_label, or braze_id is required
external_id STRING,
--If using user alias, both alias_name and alias_label are required
alias_name STRING,
alias_label STRING,
--braze_id can only be used to update existing users created through the Braze SDK
braze_id STRING,
--If you include both email and phone, email is used as the primary identifier
email STRING,
phone STRING,
payload STRING, STRUCT, or MAP
);
| Feldname | Typ | Modus |
|---|---|---|
UPDATED_AT |
TIMESTAMP | REQUIRED |
PAYLOAD |
STRING, STRUCT oder MAP | REQUIRED |
EXTERNAL_ID |
STRING | NULLABLE |
ALIAS_NAME |
STRING | NULLABLE |
ALIAS_LABEL |
STRING | NULLABLE |
BRAZE_ID |
STRING | NULLABLE |
EMAIL |
STRING | NULLABLE |
PHONE |
STRING | NULLABLE |
Sie können Schema und Tabelle beliebig benennen, die Spaltennamen sollten jedoch der vorstehenden Definition entsprechen.
UPDATED_AT- Der Zeitpunkt, zu dem diese Zeile in der Tabelle aktualisiert oder hinzugefügt wurde. Braze synchronisiert Zeilen, derenUPDATED_ATnach dem zuletzt synchronisierten Wert liegt. Zeilen mit genau dem Grenz-Zeitstempel werden möglicherweise erneut synchronisiert, wenn neue Zeilen denselben Zeitstempel haben.- Spalten für Nutzer-Bezeichner - Ihre Tabelle kann eine oder mehrere Spalten mit Nutzer-Bezeichnern enthalten. Jede Zeile sollte nur einen Bezeichner enthalten (entweder
external_id, die Kombination ausalias_nameundalias_label,braze_id,emailoderphone). Eine Quelltabelle kann Spalten für einen, zwei, drei, vier oder alle fünf Bezeichnertypen enthalten.EXTERNAL_ID- Damit wird die Nutzer:in identifiziert, die Sie aktualisieren möchten. Dieser Wert sollte mit dem in Braze verwendetenexternal_id-Wert übereinstimmen.ALIAS_NAMEundALIAS_LABEL- Diese beiden Spalten erstellen ein Nutzer-Alias-Objekt.alias_namesollte ein eindeutiger Bezeichner sein, undalias_labelgibt den Typ des Alias an. Nutzer:innen können mehrere Aliase mit unterschiedlichen Labels haben, aber nur einenalias_nameproalias_label.BRAZE_ID- Der Braze-Nutzer-Bezeichner. Er wird vom Braze SDK generiert, und über Cloud Data Ingestion können keine neuen Nutzer:innen mit einer Braze-ID erstellt werden. Um neue Nutzer:innen zu erstellen, geben Sie eine externe Nutzer-ID oder einen Nutzer-Alias an.EMAIL- Die E-Mail-Adresse der Nutzer:in. Wenn mehrere Profile mit derselben E-Mail-Adresse existieren, wird das zuletzt aktualisierte Profil bei Updates priorisiert. Wenn Sie sowohl E-Mail-Adresse als auch Telefonnummer angeben, wird die E-Mail-Adresse als primärer Bezeichner verwendet.PHONE- Die Telefonnummer der Nutzer:in. Wenn mehrere Profile mit derselben Telefonnummer existieren, wird das zuletzt aktualisierte Profil bei Updates priorisiert.
PAYLOAD- Dies ist ein String oder Struct mit den Feldern, die Sie mit der Nutzer:in in Braze synchronisieren möchten.
Schritt 1.2: Zugangsdaten für Braze erstellen
Braze kann sich mit einer der folgenden Authentifizierungsmethoden mit Databricks verbinden:
- OAuth M2M (empfohlen): Braze authentifiziert sich als Databricks-Service-Principal mit einer Client-ID und einem Client-Geheimnis. Databricks empfiehlt die OAuth-M2M-Authentifizierung für unbeaufsichtigte Verbindungen wie Cloud Data Ingestion.
- Persönliches Zugriffstoken: Braze authentifiziert sich mit einem Token, das in Ihrem Databricks-Workspace generiert wurde.
Bestehende Zugangsdaten mit persönlichem Zugriffstoken funktionieren weiterhin, und Sie müssen sie nicht migrieren. Persönliche Zugriffstoken laufen jedoch häufig nach einem von Ihrer Workspace-Administration festgelegten Zeitplan ab, und Synchronisierungen werden beendet, sobald das Token abläuft. Um eine bestehende Quelle auf OAuth M2M umzustellen, erstellen Sie OAuth-M2M-Zugangsdaten und wählen Sie diese beim Bearbeiten der Quelle aus.
Braze verbindet sich mit Ihrem Databricks-Workspace über einen Service Principal mit OAuth-M2M-Authentifizierung. Erstellen Sie einen neuen Service Principal für Braze und gewähren Sie ihm Zugriff auf Ihr SQL-Warehouse und Ihre Quelltabellen. Braze benötigt die folgenden Angaben für die Verbindung:
- Client-ID (auch Anwendungs-ID genannt) des Service Principal
- Client-Geheimnis, mit dem sich Braze authentifiziert
Service Principal erstellen
- Wählen Sie in Ihrem Databricks-Workspace in der oberen Leiste Ihren Nutzernamen und anschließend Settings aus.
- Gehen Sie zu Identity and access und wählen Sie neben Service principals die Option Manage aus.
- Wählen Sie Add service principal > Add new aus.
- Geben Sie einen Namen ein, an dem Sie den Service Principal erkennen, z. B. „Braze CDI“, und wählen Sie dann Add aus.
- Wählen Sie den erstellten Service Principal aus. Stellen Sie im Tab Configurations sicher, dass Databricks SQL access ausgewählt ist.
Client-Geheimnis generieren
- Wählen Sie auf der Seite des Service Principal den Tab Secrets und anschließend Generate secret aus.
- Geben Sie eine Lifetime für das Geheimnis in Tagen ein. Databricks erlaubt eine maximale Lifetime von 730 Tagen.
- Wählen Sie Generate aus.
- Kopieren Sie die Werte Secret und Client ID und wählen Sie dann Done aus.
Bewahren Sie Client-ID und Geheimnis an einem sicheren Ort auf, bis Sie sie beim Erstellen der Zugangsdaten im Braze-Dashboard eingeben müssen. Databricks zeigt das Geheimnis nur einmal an.
Databricks erlaubt keine unbegrenzte Lifetime für Geheimnisse von Service Principals. Denken Sie daran, das Geheimnis vor dem Ablauf zu ersetzen, damit der Datenfluss zu Braze nicht unterbrochen wird. Die einzelnen Schritte finden Sie unter Client-Geheimnis aktualisieren.
Zugriff auf das SQL-Warehouse gewähren
Braze benötigt die Berechtigung, Abfragen in Ihrem SQL-Warehouse auszuführen, aber keinen Administratorzugriff auf den Workspace.
- Wählen Sie in der Seitenleiste SQL Warehouses und dann das Warehouse aus, das Braze verwenden soll.
- Wählen Sie Permissions aus.
- Suchen Sie nach dem erstellten Service Principal und wählen Sie ihn aus.
- Wählen Sie im Dropdown-Menü für Berechtigungen Can use und anschließend Add aus.
Zugriff auf die Quelltabellen gewähren
Gewähren Sie dem Service Principal Lesezugriff auf den Katalog, das Schema und die Tabellen, die Sie in Schritt 1.1 eingerichtet haben. Verwenden Sie als Empfänger der Berechtigung die Anwendungs-ID des Service Principal (derselbe Wert wie die Client-ID).
GRANT USE CATALOG ON CATALOG `BRAZE-CLOUD-PRODUCTION` TO `APPLICATION_ID`;
GRANT USE SCHEMA ON SCHEMA `BRAZE-CLOUD-PRODUCTION`.INGESTION TO `APPLICATION_ID`;
GRANT SELECT ON TABLE `BRAZE-CLOUD-PRODUCTION`.INGESTION.USERS_ATTRIBUTES_SYNC TO `APPLICATION_ID`;
Ersetzen Sie APPLICATION_ID durch die Anwendungs-ID Ihres Service Principal. Passen Sie die anderen Namen bei Bedarf an, die Berechtigungen sollten jedoch dem vorstehenden Beispiel entsprechen.
Client-Geheimnis aktualisieren
Braze speichert ein Client-Geheimnis pro Zugangsdaten. Wenn Sie es aktualisieren, wechseln alle Quellen und Synchronisierungen, die diese Zugangsdaten verwenden, zum neuen Geheimnis. So ersetzen Sie das Geheimnis:
- Generieren Sie in Databricks ein neues Geheimnis für den Service Principal. Folgen Sie dazu den Schritten unter Client-Geheimnis generieren. Behalten Sie das alte Geheimnis bis Schritt 6.
- Gehen Sie im Braze-Dashboard zu Dateneinstellungen > Cloud Data Ingestion > Zugangsdaten und wählen Sie Ihre OAuth-M2M-Zugangsdaten aus. Im Abschnitt Verwendet von werden alle Quellen und Synchronisierungen aufgeführt, die diese Zugangsdaten verwenden.
- Pausieren Sie die Synchronisierungen, die diese Zugangsdaten verwenden, oder planen Sie das Update für einen Zeitpunkt, an dem keine davon ausgeführt wird. So verhindern Sie, dass eine Synchronisierung startet, während Sie die Zugangsdaten aktualisieren.
- Wählen Sie Zugangsdaten bearbeiten aus, geben Sie das neue Client-Geheimnis ein und wählen Sie dann Speichern aus. Die Änderung gilt für alle Quellen und Synchronisierungen, die diese Zugangsdaten verwenden.
- Setzen Sie alle pausierten Synchronisierungen fort.
- Nachdem Braze das neue Geheimnis gespeichert hat, löschen Sie das alte Geheimnis in Databricks.
Damit Braze auf Databricks zugreifen kann, muss ein persönliches Zugriffstoken erstellt werden.
- Wählen Sie in Ihrem Databricks-Workspace in der oberen Leiste Ihren Databricks-Nutzernamen und anschließend im Dropdown-Menü User Settings aus.
- Wählen Sie im Tab „Access tokens“ die Option Generate new token aus.
- Geben Sie einen Kommentar ein, an dem Sie dieses Token erkennen, z. B. „Braze CDI“, und setzen Sie die Lifetime des Tokens auf unbegrenzt, indem Sie das Feld „Lifetime (days)“ leer lassen.
- Wählen Sie Generate aus.
- Kopieren Sie das angezeigte Token und wählen Sie dann Done aus.
Bewahren Sie das Token an einem sicheren Ort auf, bis Sie es beim Erstellen der Zugangsdaten im Braze-Dashboard eingeben müssen.
Schritt 1.3: Zugriff für Braze-IPs zulassen
Wenn Sie Netzwerkrichtlinien verwenden, müssen Sie Braze Netzwerkzugriff auf Ihre Databricks-Instanz gewähren. Lassen Sie den Zugriff von den folgenden IPs zu, die der Region Ihres Braze-Dashboards entsprechen.
Für die Instanzen US-01, US-02, US-03, US-04, US-05, US-06, US-07 sind dies die relevanten IP-Adressen:
23.21.118.19134.206.23.17350.16.249.952.4.160.21454.87.8.3454.156.35.25152.54.89.23818.205.178.15
Für die Instanz US-08 sind dies die relevanten IP-Adressen:
52.151.246.5152.170.163.18240.76.166.15740.76.166.17040.76.166.16740.76.166.16140.76.166.15640.76.166.16640.76.166.16040.88.51.7452.154.67.1740.76.166.8040.76.166.8440.76.166.8540.76.166.8140.76.166.7140.76.166.14440.76.166.145
Für die Instanz US-10 sind dies die relevanten IP-Adressen:
100.25.232.16435.168.86.17952.7.44.1173.92.153.1835.172.3.12950.19.162.19
Für die Instanzen EU-01 und EU-02 sind dies die relevanten IP-Adressen:
52.58.142.24252.29.193.12135.158.29.22818.157.135.973.123.166.463.64.27.363.65.88.253.68.144.1883.70.107.88
Für die Instanz AU-01 sind dies die relevanten IP-Adressen:
13.210.1.14513.211.70.15913.238.45.5452.65.73.16754.153.242.23954.206.45.213
Für die Instanz ID-01 sind dies die relevanten IP-Adressen:
108.136.157.246108.137.30.20716.78.128.7116.78.14.13416.78.162.20843.218.73.35
Für die Instanz JP-01 sind dies die relevanten IP-Adressen:
13.159.155.21254.199.221.24113.192.23.1654.250.120.13918.181.114.2323.114.38.100
Für die Instanz KR-01 sind dies die relevanten IP-Adressen:
43.200.215.452.79.67.17552.79.113.603.34.212.9254.116.134.2313.37.197.225
Schritt 1.1: Service Principal einrichten und Zugriff gewähren
Braze verbindet sich mit Ihrem Fabric-Warehouse über einen Service Principal mit Entra-ID-Authentifizierung. Erstellen Sie einen neuen Service Principal für Braze und gewähren Sie bei Bedarf Zugriff auf Fabric-Ressourcen. Braze benötigt die folgenden Angaben für die Verbindung:
- Mandanten-ID (auch als Verzeichnis bezeichnet) für Ihr Azure-Konto
- Prinzipal-ID (auch als Anwendungs-ID bezeichnet) für den Dienstprinzipal
- Client-Secret für die Authentifizierung durch Braze
- Navigieren Sie im Azure-Portal zum Microsoft Entra Admin Center und dann zu App Registrations.
- Wählen Sie + New registration unter Identity > Applications > App registrations aus.
- Geben Sie einen Namen ein und wählen Sie
Accounts in this organizational directory onlyals unterstützten Kontotyp aus. Wählen Sie dann Register aus. - Wählen Sie die soeben erstellte Anwendung (Dienstprinzipal) aus und navigieren Sie dann zu Certificates & secrets > + New client secret.
- Geben Sie eine Beschreibung für das Secret ein und legen Sie einen Ablaufzeitraum für das Secret fest. Wählen Sie dann Add aus.
- Notieren Sie sich das erstellte Client-Secret, um es bei der Braze-Einrichtung zu verwenden.
Azure erlaubt keinen unbegrenzten Ablauf für Geheimnisse von Service Principals. Denken Sie daran, die Zugangsdaten vor dem Ablauf zu erneuern, damit der Datenfluss zu Braze nicht unterbrochen wird.
Schritt 1.2: Zugriff auf Fabric-Ressourcen gewähren
Gewähren Sie Braze Zugriff, um sich mit Ihrer Fabric-Instanz zu verbinden. Navigieren Sie in Ihrem Fabric-Admin-Portal zu Settings > Governance and insights > Admin portal > Tenant settings.
- Aktivieren Sie unter Developer settings die Option Service principals can use Fabric APIs, damit Braze sich über Microsoft Entra ID verbinden kann.
- Aktivieren Sie unter OneLake settings die Option Users can access data stored in OneLake with apps external to Fabric, damit der Service Principal über eine externe App auf Daten zugreifen kann.
Schritt 1.3: Freigegebenen Workspace einrichten und Zugriff gewähren
Alle Fabric-Ressourcen, die Sie mit Braze verbinden möchten, müssen sich in einem freigegebenen Workspace befinden. Wenn Sie bisher nur den Standard-Workspace My Workspace verwendet haben, erstellen Sie einen neuen freigegebenen Workspace:
- Wählen Sie im Navigationsmenü Workspaces und dann + New workspace aus.
- Geben Sie einen Name für den Workspace ein und wählen Sie dann Apply aus.
Sobald Sie einen freigegebenen Workspace haben, gewähren Sie dem Service Principal Zugriff:
- Wählen Sie den Workspace und dann Manage Access aus.
- Wählen Sie + Add people or groups aus.
- Suchen Sie nach dem Namen des Service Principal, den Sie in Schritt 1.1 erstellt haben, und wählen Sie ihn aus. Wenn er nicht angezeigt wird, prüfen Sie, ob Sie in Schritt 1.2 die Einstellung Service principals can use Fabric APIs aktiviert haben.
- Wählen Sie im Dropdown-Menü für Rollen Contributor aus.
Der Service Principal kann nun über die SQL-Endpunkte auf die Fabric-Warehouse-Ressourcen in diesem Workspace zugreifen, einschließlich des Warehouse, das Sie für Braze verwenden.
Schritt 1.4: Tabelle einrichten
Braze unterstützt in Fabric-Warehouses sowohl Tabellen als auch Ansichten. Wenn Sie ein neues Warehouse erstellen müssen, erstellen Sie es im freigegebenen Workspace aus Schritt 1.3. Gehen Sie dazu in der Fabric-Konsole zu Create > Data Warehouse > Warehouse.
CREATE OR ALTER TABLE [warehouse].[schema].[CDI_table_name]
(
UPDATED_AT DATETIME2(6) NOT NULL,
PAYLOAD VARCHAR NOT NULL,
--at least one of external_id, alias_name and alias_label, email, phone, or braze_id is required
EXTERNAL_ID VARCHAR,
--if using user alias, both alias_name and alias_label are required
ALIAS_NAME VARCHAR,
ALIAS_LABEL VARCHAR,
--braze_id can only be used to update existing users created through the Braze SDK
BRAZE_ID VARCHAR,
--If you include both email and phone, email is used as the primary identifier
EMAIL VARCHAR,
PHONE VARCHAR
)
GO
Sie können Warehouse, Schema und Tabelle oder Ansicht beliebig benennen, die Spaltennamen sollten jedoch der vorstehenden Definition entsprechen.
UPDATED_AT- Der Zeitpunkt, zu dem diese Zeile in der Tabelle aktualisiert oder hinzugefügt wurde. Braze synchronisiert Zeilen, derenUPDATED_ATnach dem zuletzt synchronisierten Wert liegt. Zeilen mit genau dem Grenz-Zeitstempel werden möglicherweise erneut synchronisiert, wenn neue Zeilen denselben Zeitstempel haben.- Spalten für Nutzer-Bezeichner - Ihre Tabelle kann eine oder mehrere Spalten mit Nutzer-Bezeichnern enthalten. Jede Zeile sollte nur einen Bezeichner enthalten (entweder
external_id, die Kombination ausalias_nameundalias_label,braze_id,emailoderphone). Eine Quelltabelle kann Spalten für einen, zwei, drei, vier oder alle fünf Bezeichnertypen enthalten.EXTERNAL_ID- Damit wird die Nutzer:in identifiziert, die Sie aktualisieren möchten. Dieser Wert sollte mit dem in Braze verwendetenexternal_id-Wert übereinstimmen.ALIAS_NAMEundALIAS_LABEL- Diese beiden Spalten erstellen ein Nutzer-Alias-Objekt.alias_namesollte ein eindeutiger Bezeichner sein, undalias_labelgibt den Typ des Alias an. Nutzer:innen können mehrere Aliase mit unterschiedlichen Labels haben, aber nur einenalias_nameproalias_label.BRAZE_ID- Der Braze-Nutzer-Bezeichner. Er wird vom Braze SDK generiert, und über Cloud Data Ingestion können keine neuen Nutzer:innen mit einer Braze-ID erstellt werden. Um neue Nutzer:innen zu erstellen, geben Sie eine externe Nutzer-ID oder einen Nutzer-Alias an.EMAIL- Die E-Mail-Adresse der Nutzer:in. Wenn mehrere Profile mit derselben E-Mail-Adresse existieren, wird das zuletzt aktualisierte Profil bei Updates priorisiert. Wenn Sie sowohl E-Mail-Adresse als auch Telefonnummer angeben, wird die E-Mail-Adresse als primärer Bezeichner verwendet.PHONE- Die Telefonnummer der Nutzer:in. Wenn mehrere Profile mit derselben Telefonnummer existieren, wird das zuletzt aktualisierte Profil bei Updates priorisiert.
PAYLOAD- Dies ist ein JSON-String mit den Feldern, die Sie mit der Nutzer:in in Braze synchronisieren möchten.
Schritt 1.5: Verbindungsstring des Warehouse abrufen
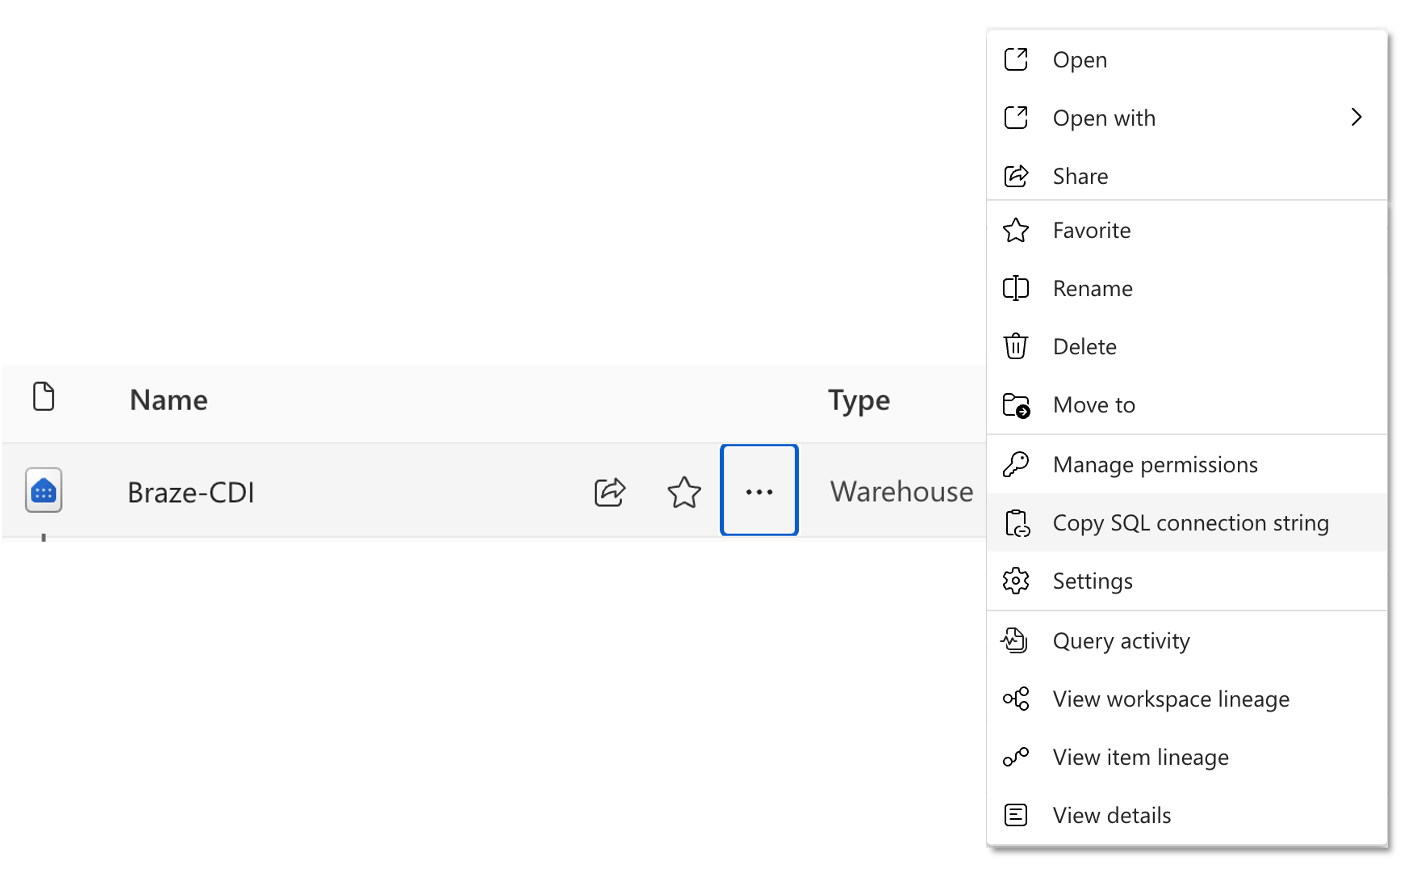
Um den SQL-Endpunkt Ihres Warehouse abzurufen, gehen Sie in Fabric zum workspace, bewegen Sie den Mauszeiger in der Elementliste über den Namen des Warehouse und wählen Sie Copy SQL connection string aus.
Schritt 1.6: Braze-IPs in der Firewall zulassen (optional)
Je nach Konfiguration Ihres Microsoft-Fabric-Kontos müssen Sie die folgenden IP-Adressen möglicherweise in Ihrer Firewall zulassen, um Datenverkehr von Braze zu erlauben. Weitere Informationen dazu finden Sie in der Dokumentation zu Entra Conditional Access.
Für die Instanzen US-01, US-02, US-03, US-04, US-05, US-06, US-07 sind dies die relevanten IP-Adressen:
23.21.118.19134.206.23.17350.16.249.952.4.160.21454.87.8.3454.156.35.25152.54.89.23818.205.178.15
Für die Instanz US-08 sind dies die relevanten IP-Adressen:
52.151.246.5152.170.163.18240.76.166.15740.76.166.17040.76.166.16740.76.166.16140.76.166.15640.76.166.16640.76.166.16040.88.51.7452.154.67.1740.76.166.8040.76.166.8440.76.166.8540.76.166.8140.76.166.7140.76.166.14440.76.166.145
Für die Instanz US-10 sind dies die relevanten IP-Adressen:
100.25.232.16435.168.86.17952.7.44.1173.92.153.1835.172.3.12950.19.162.19
Für die Instanzen EU-01 und EU-02 sind dies die relevanten IP-Adressen:
52.58.142.24252.29.193.12135.158.29.22818.157.135.973.123.166.463.64.27.363.65.88.253.68.144.1883.70.107.88
Für die Instanz AU-01 sind dies die relevanten IP-Adressen:
13.210.1.14513.211.70.15913.238.45.5452.65.73.16754.153.242.23954.206.45.213
Für die Instanz ID-01 sind dies die relevanten IP-Adressen:
108.136.157.246108.137.30.20716.78.128.7116.78.14.13416.78.162.20843.218.73.35
Für die Instanz JP-01 sind dies die relevanten IP-Adressen:
13.159.155.21254.199.221.24113.192.23.1654.250.120.13918.181.114.2323.114.38.100
Für die Instanz KR-01 sind dies die relevanten IP-Adressen:
43.200.215.452.79.67.17552.79.113.603.34.212.9254.116.134.2313.37.197.225
Schritt 2: Neue Quelle im Braze-Dashboard erstellen
Gehen Sie im Braze-Dashboard zu Dateneinstellungen > Cloud Data Ingestion > Quellen, wählen Sie Datenquelle hinzufügen und dann Snowflake aus.
Schritt 2.1: Snowflake-Verbindungsinformationen hinzufügen
Wählen Sie einen Namen für Ihre Quelle. Geben Sie einen Namen für die Zugangsdaten ein und wählen Sie dann Workload Identity Federation oder Schlüsselpaar aus, passend zu der Nutzer:in, die Sie in Schritt 1.4 erstellt haben.
Überprüfen Sie vor dem Fortfahren den Wert, den Sie unter Snowflake Account Locator eingeben.
Geben Sie im Feld Snowflake Account Locator Ihren Snowflake-Kontobezeichner ein. Geben Sie nur den Wert des Kontobezeichners ein, z. B. myorganization-myaccount. Fügen Sie weder https:// noch .snowflakecomputing.com oder einen Pfad hinzu.
So finden Sie Ihren Snowflake-Kontobezeichner:
- Wählen Sie in Snowsight Ihr Kontomenü aus.
- Wählen Sie View account details aus.
- Kopieren Sie den Wert Account identifier.
- Wenn Sie ihn aus einer Snowflake-URL kopieren, verwenden Sie nur den Wert vor
.snowflakecomputing.com.
Schritt 2.2: Snowflake-Nutzer:in authentifizieren
Führen Sie im Formular für Zugangsdaten die Schritte in dieser Reihenfolge aus:
- Geben Sie Account Locator, Nutzername und Rolle ein.
- Wählen Sie Nutzer:in erstellen oder Nutzer:in ändern und anschließend Anweisung kopieren aus, sobald diese Option verfügbar ist.
- Führen Sie diese Anweisung in einem Snowflake-Worksheet aus. Was die Anweisung bewirkt, erfahren Sie unter Snowflake für Workload Identity Federation konfigurieren.
- Kehren Sie zu Braze zurück und wählen Sie Zugangsdaten speichern aus.
- Geben Sie Warehouse, Datenbank und Schema ein, wählen Sie Verbindung testen und dann Mit Quelle verbinden aus.
Geben Sie Account Locator, Nutzername und Rolle ein und wählen Sie dann Zugangsdaten speichern und RSA-Schlüssel generieren aus. Fügen Sie in Snowflake den im Dashboard angezeigten Public Key der Nutzer:in hinzu, die Sie für Braze erstellt haben.
Weitere Informationen dazu finden Sie in der Snowflake-Dokumentation. Wenn Sie die Schlüssel zu einem beliebigen Zeitpunkt rotieren möchten, kann Braze ein neues Schlüsselpaar generieren und den neuen Public Key bereitstellen.
ALTER USER BRAZE_INGESTION_USER SET RSA_PUBLIC_KEY='MIIBIjANBgkqhkiG9w0BA...';
Um den Schlüssel später zu rotieren, gehen Sie zu Dateneinstellungen > Cloud Data Ingestion > Zugangsdaten, öffnen Sie die Zugangsdaten unter Snowflake-Zugangsdaten für den Datenzugriff und wählen Sie Zugangsdaten rotieren aus. Informationen zum Detail-Modal finden Sie unter Snowflake-Zugangsdaten überprüfen.
Nachdem Sie den Schlüssel in Snowflake hinzugefügt haben, wählen Sie Verbindung testen und dann Mit Quelle verbinden aus.
Gehen Sie im Braze-Dashboard zu Dateneinstellungen > Cloud Data Ingestion > Quellen, wählen Sie Datenquelle hinzufügen und dann Amazon Redshift aus.
Schritt 2.1: Redshift-Verbindungsinformationen und Quelltabelle hinzufügen
Wählen Sie einen Namen für Ihre Quelle und geben Sie Ihre Redshift-Zugangsdaten und -Konfiguration ein. Wenn Sie einen privaten Netzwerktunnel verwenden, schalten Sie den Schieberegler um und geben Sie die Tunnelinformationen ein. Fahren Sie dann mit dem nächsten Schritt fort.
Im Braze-Dashboard akzeptiert das Feld Datenbankname nur Buchstaben (A–Z, a–z), Ziffern (0–9) und Unterstriche (_), obwohl Amazon Redshift weitere Zeichen in Datenbank-Bezeichnern unterstützt.
Schritt 2.2: Verbindung testen und mit der Quelle verbinden
Wählen Sie anschließend Verbindung testen aus. Ist der Test erfolgreich, schließen Sie die übrigen Einstellungen ab und wählen Sie Mit Quelle verbinden aus. Schlägt die Verbindung fehl, wird eine Fehlermeldung angezeigt, die Ihnen bei der Fehlerbehebung hilft.
Fehlerbehebung: Ungültiger Snapshot-Bezeichner
Wenn Braze beim Verbindungstest oder bei der Einrichtung der Synchronisierung den Fehler Invalid snapshot identifier zurückgibt, kann Redshift die Snapshot-Referenz nicht auflösen, die bei der Abfrage Ihres Quellobjekts verwendet wird.
In Redshift ist ein Snapshot eine Sicherung eines Clusters zu einem bestimmten Zeitpunkt. Jeder Snapshot hat einen eindeutigen Bezeichner, mit dem Redshift auf diesen Sicherungsstand verweist. Weitere Informationen finden Sie unter Amazon-Redshift-Snapshots und -Sicherungen.
Dieser Fehler kann auftreten, wenn sich Metadaten ändern, während Braze das Quellobjekt validiert, z. B. bei Vorgängen zum Kopieren, Wiederherstellen oder Replizieren von Snapshots. Weitere Informationen finden Sie unter Snapshots in eine andere AWS-Region kopieren und Cluster aus einem Snapshot wiederherstellen.
So beheben Sie den Fehler:
- Überprüfen Sie die Quelleinstellungen in Braze, einschließlich Cluster-Endpunkt, Datenbank, Schema und Objektname.
- Führen Sie dieselbe Abfrage direkt in Redshift aus, um zu bestätigen, dass die Tabelle oder Ansicht lesbar und stabil ist.
- Versuchen Sie es erneut, nachdem laufende Snapshot-, Wiederherstellungs-, Größenänderungs- oder Replikationsvorgänge abgeschlossen sind.
- Wenn das Problem weiterhin besteht, fragen Sie eine materialisierte Ansicht statt einer häufig geänderten Basistabelle ab.
Eine materialisierte Ansicht speichert vorberechnete Abfrageergebnisse, die Sie nach einem Zeitplan aktualisieren können. Dadurch können Lesevorgänge für CDI-Synchronisierungen stabiler werden. Weitere Informationen finden Sie unter Materialisierte Ansichten in Amazon Redshift.
Beispiel:
CREATE MATERIALIZED VIEW ingestion.users_attributes_mv AS
SELECT updated_at, external_id, alias_label, alias_name, braze_id, email, phone, payload
FROM ingestion.users_attributes_sync;
REFRESH MATERIALIZED VIEW ingestion.users_attributes_mv;
Nachdem Sie die materialisierte Ansicht erstellt haben, verwenden Sie in Ihrer Braze-CDI-Synchronisierung den Namen der materialisierten Ansicht anstelle der Basistabelle als Quellobjekt.
Gehen Sie im Braze-Dashboard zu Dateneinstellungen > Cloud Data Ingestion > Quellen, wählen Sie Datenquelle hinzufügen und dann Google BigQuery aus.
Schritt 2.1: BigQuery-Verbindungsinformationen und Quelltabelle hinzufügen
Geben Sie einen Namen für Ihre Quelle ein und anschließend Ihre BigQuery-Zugangsdaten und -Konfiguration:
- Geben Sie unter Name der Zugangsdaten eine Bezeichnung ein, an der Sie diese Zugangsdaten in Braze erkennen.
- Wählen Sie als Authentifizierungsmethode Workload Identity Federation oder Dienstkontoschlüssel aus, passend zu den Zugangsdaten, die Sie in Schritt 1.2 erstellt haben.
- Kopieren Sie bei Workload Identity Federation den Braze principal ARN für Ihre Google-Cloud-Einrichtung und geben Sie dann Projektnummer, Workload-Identity-Pool-ID, Anbieter-ID und E-Mail-Adresse des Dienstkontos ein. Bei einem Dienstkontoschlüssel laden Sie den JSON-Schlüssel hoch.
Füllen Sie dann die übrigen Konfigurationsfelder aus.
Schritt 2.2: Verbindung testen und mit der Quelle verbinden
Wählen Sie anschließend Verbindung testen aus. Ist der Test erfolgreich, schließen Sie die übrigen Einstellungen ab und wählen Sie Mit Quelle verbinden aus. Schlägt die Verbindung fehl, wird eine Fehlermeldung angezeigt, die Ihnen bei der Fehlerbehebung hilft.
Gehen Sie im Braze-Dashboard zu Dateneinstellungen > Cloud Data Ingestion > Quellen, wählen Sie Datenquelle hinzufügen und dann Databricks aus.
Schritt 2.1: Databricks-Verbindungsinformationen und Quelltabelle hinzufügen
Geben Sie einen Namen für Ihre Quelle ein und anschließend Ihre Databricks-Zugangsdaten und -Konfiguration:
- Geben Sie unter Name der Zugangsdaten eine Bezeichnung ein, an der Sie diese Zugangsdaten in Braze erkennen.
- Wählen Sie unter Authentifizierungsmethode OAuth M2M oder Persönliches Zugriffstoken aus, passend zu den Zugangsdaten, die Sie in Schritt 1.2 erstellt haben.
- Geben Sie bei OAuth M2M die Client-ID und das Client-Geheimnis Ihres Service Principal ein. Bei einem persönlichen Zugriffstoken geben Sie das Zugriffstoken ein.
Fahren Sie dann mit dem nächsten Schritt fort.
Schritt 2.2: Verbindung testen und mit der Quelle verbinden
Wählen Sie anschließend Verbindung testen aus. Ist der Test erfolgreich, schließen Sie die übrigen Einstellungen ab und wählen Sie Mit Quelle verbinden aus. Schlägt die Verbindung fehl, wird eine Fehlermeldung angezeigt, die Ihnen bei der Fehlerbehebung hilft.
Eine Quelle muss erfolgreich getestet werden, bevor sie erstellt werden kann. Wenn Sie die Erstellungsseite schließen, wird Ihre Quelle nicht gespeichert.
Gehen Sie im Braze-Dashboard zu Dateneinstellungen > Cloud Data Ingestion > Quellen, wählen Sie Datenquelle hinzufügen und dann Microsoft Fabric aus.
Schritt 2.1: Cloud-Data-Ingestion-Synchronisierung einrichten
Wählen Sie einen Namen für Ihre Quelle und geben Sie Ihre Microsoft-Fabric-Zugangsdaten und -Konfiguration ein.
- Name der Zugangsdaten ist eine Bezeichnung für diese Zugangsdaten in Braze. Hier können Sie einen aussagekräftigen Wert festlegen.
- Wie Sie Mandanten-ID, Principal-ID, Client-Geheimnis und Verbindungsstring abrufen, erfahren Sie in den Schritten in Abschnitt 1.
Schritt 2.2: Verbindung testen und mit der Quelle verbinden
Wählen Sie anschließend Verbindung testen aus. Ist der Test erfolgreich, schließen Sie die übrigen Einstellungen ab und wählen Sie Mit Quelle verbinden aus. Schlägt die Verbindung fehl, wird eine Fehlermeldung angezeigt, die Ihnen bei der Fehlerbehebung hilft.
Eine Quelle muss erfolgreich getestet werden, bevor sie erstellt werden kann. Wenn Sie die Erstellungsseite schließen, wird Ihre Quelle nicht gespeichert.
Schritt 3: Neue Synchronisierung im Braze-Dashboard erstellen
Gehen Sie zu Dateneinstellungen > Cloud Data Ingestion > Synchronisierungen und wählen Sie Datensynchronisierung erstellen aus.
Schritt 3.1: Synchronisierungsdetails konfigurieren und Daten definieren
Geben Sie einen Namen für Ihre Synchronisierung ein. Wählen Sie dann eine aktive Quelle und einen Datentyp für die Synchronisierung aus. Wählen Sie anschließend Visuell oder Tabelle aus und geben Sie Ihre Quelltabelle ein, oder wählen Sie SQL aus, um eine angepasste SQL-Abfrage zu schreiben. Wählen Sie abschließend Vorschau und Validierung aus.
Nach erfolgreicher Validierung wird eine Vorschau der Daten angezeigt. Wählen Sie Weiter: Benachrichtigungen aus, um fortzufahren. Schlägt die Validierung fehl, wird eine Fehlermeldung angezeigt, die Ihnen bei der Fehlerbehebung hilft.
Eine Synchronisierung muss erfolgreich validiert werden, bevor Sie mit den nächsten Schritten fortfahren können. Wenn Sie die Seite zur Erstellung der Synchronisierung schließen müssen, wählen Sie Als Entwurf speichern aus, um Ihren Arbeitsstand zu sichern.
Schritt 3.2: Benachrichtigungseinstellungen hinzufügen
Geben Sie Kontakt-E-Mail-Adressen für Benachrichtigungen über Synchronisierungsfehler ein. Braze verwendet diese Kontaktinformationen, um Benachrichtigungen über Integrationsfehler zu senden, z. B. bei einem unerwarteten Verlust des Tabellenzugriffs.
Kontakt-E-Mail-Adressen erhalten nur Benachrichtigungen über globale Fehler oder Fehler auf Synchronisierungsebene, z. B. fehlende Tabellen, Berechtigungen und Ähnliches. Probleme auf Zeilenebene werden nicht gemeldet. Globale Fehler weisen auf kritische Verbindungsprobleme hin, die die Ausführung von Synchronisierungen verhindern.
Zu diesen Problemen gehören:
- Verbindungsprobleme
- Fehlende Ressourcen
- Berechtigungsprobleme
- Kein Speicherplatz mehr im Katalog-Tier (nur Katalog-Synchronisierungen)
Schritt 3.3: Planung
Konfigurieren Sie Ihre Synchronisierung abschließend als einmalig oder wiederkehrend.
Einmalige Synchronisierungen werden nur ausgeführt, wenn Sie im Dashboard Jetzt synchronisieren auswählen oder den Endpunkt Synchronisierung triggern aufrufen.
Wiederkehrende Synchronisierungen können bis zu alle 5 Minuten oder nur einmal pro Monat ausgeführt werden. Standardmäßig beträgt das kürzeste Intervall, das Sie im Dashboard festlegen können, 15 Minuten. Das hilft Ihnen, die Rechenkosten Ihres Warehouse und das Anfragevolumen zu steuern. Wenn Sie bis zu alle 5 Minuten synchronisieren möchten, wenden Sie sich an den Braze-Support oder Ihr:e Customer-Success-Manager:in. Braze plant wiederkehrende Synchronisierungen in UTC.
Schritt 3.1: Synchronisierungsdetails konfigurieren und Daten definieren
Geben Sie einen Namen für Ihre Synchronisierung ein. Wählen Sie dann eine aktive Quelle und einen Datentyp für die Synchronisierung aus. Wählen Sie anschließend Visuell oder Tabelle aus und geben Sie Ihre Quelltabelle ein, oder wählen Sie SQL aus, um eine angepasste SQL-Abfrage zu schreiben. Wählen Sie abschließend Vorschau und Validierung aus.
Nach erfolgreicher Validierung wird eine Vorschau der Daten angezeigt. Wählen Sie Weiter: Benachrichtigungen aus, um fortzufahren. Schlägt die Validierung fehl, wird eine Fehlermeldung angezeigt, die Ihnen bei der Fehlerbehebung hilft.
Eine Synchronisierung muss erfolgreich validiert werden, bevor Sie mit den nächsten Schritten fortfahren können. Wenn Sie die Seite zur Erstellung der Synchronisierung schließen müssen, wählen Sie Als Entwurf speichern aus, um Ihren Arbeitsstand zu sichern.
Schritt 3.2: Benachrichtigungseinstellungen hinzufügen
Geben Sie Kontakt-E-Mail-Adressen für Benachrichtigungen über Synchronisierungsfehler ein. Braze verwendet diese Kontaktinformationen, um Benachrichtigungen über Integrationsfehler zu senden, z. B. bei einem unerwarteten Verlust des Tabellenzugriffs.
Kontakt-E-Mail-Adressen erhalten nur Benachrichtigungen über globale Fehler oder Fehler auf Synchronisierungsebene, z. B. fehlende Tabellen, Berechtigungen und Ähnliches. Probleme auf Zeilenebene werden nicht gemeldet. Globale Fehler weisen auf kritische Verbindungsprobleme hin, die die Ausführung von Synchronisierungen verhindern. Zu diesen Problemen gehören:
- Verbindungsprobleme
- Fehlende Ressourcen
- Berechtigungsprobleme
- Kein Speicherplatz mehr im Katalog-Tier (nur Katalog-Synchronisierungen)
Schritt 3.3: Planung
Konfigurieren Sie Ihre Synchronisierung abschließend als einmalig oder wiederkehrend.
Einmalige Synchronisierungen werden nur ausgeführt, wenn Sie im Dashboard Jetzt synchronisieren auswählen oder den Endpunkt Synchronisierung triggern aufrufen.
Wiederkehrende Synchronisierungen können bis zu alle 5 Minuten oder nur einmal pro Monat ausgeführt werden. Standardmäßig beträgt das kürzeste Intervall, das Sie im Dashboard festlegen können, 15 Minuten. Das hilft Ihnen, die Rechenkosten Ihres Warehouse und das Anfragevolumen zu steuern. Wenn Sie bis zu alle 5 Minuten synchronisieren möchten, wenden Sie sich an den Braze-Support oder Ihr:e Customer-Success-Manager:in. Braze plant wiederkehrende Synchronisierungen in UTC.
Schritt 3.1: Synchronisierungsdetails konfigurieren und Daten definieren
Geben Sie einen Namen für Ihre Synchronisierung ein. Wählen Sie dann eine aktive Quelle und einen Datentyp für die Synchronisierung aus. Wählen Sie anschließend Visuell oder Tabelle aus und geben Sie Ihre Quelltabelle ein, oder wählen Sie SQL aus, um eine angepasste SQL-Abfrage zu schreiben. Wählen Sie abschließend Vorschau und Validierung aus.
Nach erfolgreicher Validierung wird eine Vorschau der Daten angezeigt. Wählen Sie Weiter: Benachrichtigungen aus, um fortzufahren. Schlägt die Validierung fehl, wird eine Fehlermeldung angezeigt, die Ihnen bei der Fehlerbehebung hilft.
Eine Synchronisierung muss erfolgreich validiert werden, bevor Sie mit den nächsten Schritten fortfahren können. Wenn Sie die Seite zur Erstellung der Synchronisierung schließen müssen, wählen Sie Als Entwurf speichern aus, um Ihren Arbeitsstand zu sichern.
Schritt 3.2: Benachrichtigungseinstellungen hinzufügen
Geben Sie Kontakt-E-Mail-Adressen für Benachrichtigungen über Synchronisierungsfehler ein. Braze verwendet diese Kontaktinformationen, um Benachrichtigungen über Integrationsfehler zu senden, z. B. bei einem unerwarteten Verlust des Tabellenzugriffs.
Kontakt-E-Mail-Adressen erhalten nur Benachrichtigungen über globale Fehler oder Fehler auf Synchronisierungsebene, z. B. fehlende Tabellen, Berechtigungen und Ähnliches. Probleme auf Zeilenebene werden nicht gemeldet. Globale Fehler weisen auf kritische Verbindungsprobleme hin, die die Ausführung von Synchronisierungen verhindern.
Zu diesen Problemen gehören:
- Verbindungsprobleme
- Fehlende Ressourcen
- Berechtigungsprobleme
- Kein Speicherplatz mehr im Katalog-Tier (nur Katalog-Synchronisierungen)
Schritt 3.3: Planung
Konfigurieren Sie Ihre Synchronisierung abschließend als einmalig oder wiederkehrend.
Einmalige Synchronisierungen werden nur ausgeführt, wenn Sie im Dashboard Jetzt synchronisieren auswählen oder den Endpunkt Synchronisierung triggern aufrufen.
Wiederkehrende Synchronisierungen können bis zu alle 5 Minuten oder nur einmal pro Monat ausgeführt werden. Standardmäßig beträgt das kürzeste Intervall, das Sie im Dashboard festlegen können, 15 Minuten. Das hilft Ihnen, die Rechenkosten Ihres Warehouse und das Anfragevolumen zu steuern. Wenn Sie bis zu alle 5 Minuten synchronisieren möchten, wenden Sie sich an den Braze-Support oder Ihr:e Customer-Success-Manager:in. Braze plant wiederkehrende Synchronisierungen in UTC.
Schritt 3.1: Synchronisierungsdetails konfigurieren und Daten definieren
Geben Sie einen Namen für Ihre Synchronisierung ein. Wählen Sie dann eine aktive Quelle und einen Datentyp für die Synchronisierung aus. Wählen Sie anschließend Visuell oder Tabelle aus und geben Sie Ihre Quelltabelle ein, oder wählen Sie SQL aus, um eine angepasste SQL-Abfrage zu schreiben. Wählen Sie abschließend Vorschau und Validierung aus.
Nach erfolgreicher Validierung wird eine Vorschau der Daten angezeigt. Wählen Sie Weiter: Benachrichtigungen aus, um fortzufahren. Schlägt die Validierung fehl, wird eine Fehlermeldung angezeigt, die Ihnen bei der Fehlerbehebung hilft.
Eine Synchronisierung muss erfolgreich validiert werden, bevor Sie mit den nächsten Schritten fortfahren können. Wenn Sie die Seite zur Erstellung der Synchronisierung schließen müssen, wählen Sie Als Entwurf speichern aus, um Ihren Arbeitsstand zu sichern.
Schritt 3.2: Benachrichtigungseinstellungen hinzufügen
Geben Sie Kontakt-E-Mail-Adressen für Benachrichtigungen über Synchronisierungsfehler ein. Braze verwendet diese Kontaktinformationen, um Benachrichtigungen über Integrationsfehler zu senden, z. B. bei einem unerwarteten Verlust des Tabellenzugriffs.
Kontakt-E-Mail-Adressen erhalten nur Benachrichtigungen über globale Fehler oder Fehler auf Synchronisierungsebene, z. B. fehlende Tabellen, Berechtigungen und Ähnliches. Probleme auf Zeilenebene werden nicht gemeldet. Globale Fehler weisen auf kritische Verbindungsprobleme hin, die die Ausführung von Synchronisierungen verhindern.
Zu diesen Problemen gehören:
- Verbindungsprobleme
- Fehlende Ressourcen
- Berechtigungsprobleme
- Kein Speicherplatz mehr im Katalog-Tier (nur Katalog-Synchronisierungen)
Schritt 3.3: Planung
Konfigurieren Sie Ihre Synchronisierung abschließend als einmalig oder wiederkehrend.
Einmalige Synchronisierungen werden nur ausgeführt, wenn Sie im Dashboard Jetzt synchronisieren auswählen oder den Endpunkt Synchronisierung triggern aufrufen.
Wiederkehrende Synchronisierungen können bis zu alle 5 Minuten oder nur einmal pro Monat ausgeführt werden. Standardmäßig beträgt das kürzeste Intervall, das Sie im Dashboard festlegen können, 15 Minuten. Das hilft Ihnen, die Rechenkosten Ihres Warehouse und das Anfragevolumen zu steuern. Wenn Sie bis zu alle 5 Minuten synchronisieren möchten, wenden Sie sich an den Braze-Support oder Ihr:e Customer-Success-Manager:in. Braze plant wiederkehrende Synchronisierungen in UTC.
Eine Integration muss erfolgreich validiert werden, bevor sie vom Status „Entwurf“ in den Status „Aktiv“ wechseln kann. Wenn Sie die Erstellungsseite schließen, wird Ihre Integration gespeichert, und Sie können die Detailseite erneut aufrufen, um Änderungen vorzunehmen und die Validierung durchzuführen.
Zusätzliche Integrationen oder Nutzer:innen einrichten (optional)
Sie können mehrere Integrationen mit Braze einrichten. Wenn Sie zusätzliche Synchronisierungen erstellen, können Sie vorhandene Zugangsdaten wiederverwenden, sofern Sie eine Verbindung zum Snowflake-Konto herstellen.
Wenn Sie dieselben Schlüsselpaar-Nutzer:innen und dieselbe Rolle für mehrere Integrationen wiederverwenden, müssen Sie den Public Key nicht erneut hinzufügen. Für Zugangsdaten mit Workload Identity Federation gibt es keinen Public Key, den Sie hinzufügen müssten.
Sie können mehrere Integrationen mit Braze einrichten. Wenn Sie zusätzliche Synchronisierungen erstellen, können Sie vorhandene Zugangsdaten wiederverwenden, sofern Sie eine Verbindung zum selben Redshift-Konto herstellen.
Wenn Sie dieselben Nutzer:innen für mehrere Integrationen wiederverwenden, können Sie diese Nutzer:innen im Braze-Dashboard erst löschen, nachdem sie aus allen aktiven Synchronisierungen entfernt wurden.
Sie können mehrere Integrationen mit Braze einrichten. Wenn Sie zusätzliche Synchronisierungen erstellen, können Sie vorhandene Zugangsdaten wiederverwenden, sofern Sie eine Verbindung zum selben BigQuery-Konto herstellen.
Wenn Sie dieselben Nutzer:innen für mehrere Integrationen wiederverwenden, können Sie diese Nutzer:innen im Braze-Dashboard erst löschen, nachdem sie aus allen aktiven Synchronisierungen entfernt wurden.
Sie können mehrere Integrationen mit Braze einrichten. Wenn Sie zusätzliche Synchronisierungen erstellen, können Sie vorhandene Zugangsdaten wiederverwenden, sofern Sie eine Verbindung zum selben Databricks-Konto herstellen.
Wenn Sie dieselben Nutzer:innen für mehrere Integrationen wiederverwenden, können Sie diese Nutzer:innen im Braze-Dashboard erst löschen, nachdem sie aus allen aktiven Synchronisierungen entfernt wurden.
Sie können mehrere Integrationen mit Braze einrichten. Wenn Sie zusätzliche Synchronisierungen erstellen, können Sie vorhandene Zugangsdaten wiederverwenden, sofern Sie eine Verbindung zum selben Fabric-Konto herstellen.
Wenn Sie dieselben Nutzer:innen für mehrere Integrationen wiederverwenden, können Sie diese Nutzer:innen im Braze-Dashboard erst löschen, nachdem sie aus allen aktiven Synchronisierungen entfernt wurden.
Synchronisierung ausführen
Nach der Aktivierung wird Ihre Synchronisierung nach dem bei der Einrichtung konfigurierten Zeitplan ausgeführt. Wenn Sie die Synchronisierung außerhalb des Zeitplans ausführen oder die neuesten Daten abrufen möchten, wählen Sie Jetzt synchronisieren. Dieser Lauf hat keine Auswirkungen auf regelmäßig geplante zukünftige Synchronisierungen. Um eine Synchronisierung automatisch zu starten, wenn Ihre Daten aktualisiert werden, rufen Sie den Endpunkt Synchronisierung triggern aus Ihrer Pipeline auf.
Nach der Aktivierung wird Ihre Synchronisierung nach dem bei der Einrichtung konfigurierten Zeitplan ausgeführt. Wenn Sie die Synchronisierung außerhalb des Zeitplans ausführen oder die neuesten Daten abrufen möchten, wählen Sie Jetzt synchronisieren. Dieser Lauf hat keine Auswirkungen auf regelmäßig geplante zukünftige Synchronisierungen. Um eine Synchronisierung automatisch zu starten, wenn Ihre Daten aktualisiert werden, rufen Sie den Endpunkt Synchronisierung triggern aus Ihrer Pipeline auf.
Nach der Aktivierung wird Ihre Synchronisierung nach dem bei der Einrichtung konfigurierten Zeitplan ausgeführt. Wenn Sie die Synchronisierung außerhalb des Zeitplans ausführen oder die neuesten Daten abrufen möchten, wählen Sie Jetzt synchronisieren. Dieser Lauf hat keine Auswirkungen auf regelmäßig geplante zukünftige Synchronisierungen. Um eine Synchronisierung automatisch zu starten, wenn Ihre Daten aktualisiert werden, rufen Sie den Endpunkt Synchronisierung triggern aus Ihrer Pipeline auf.
Nach der Aktivierung wird Ihre Synchronisierung nach dem bei der Einrichtung konfigurierten Zeitplan ausgeführt. Wenn Sie die Synchronisierung außerhalb des Zeitplans ausführen oder die neuesten Daten abrufen möchten, wählen Sie Jetzt synchronisieren. Dieser Lauf hat keine Auswirkungen auf regelmäßig geplante zukünftige Synchronisierungen. Um eine Synchronisierung automatisch zu starten, wenn Ihre Daten aktualisiert werden, rufen Sie den Endpunkt Synchronisierung triggern aus Ihrer Pipeline auf.
Nach der Aktivierung wird Ihre Synchronisierung nach dem bei der Einrichtung konfigurierten Zeitplan ausgeführt. Wenn Sie die Synchronisierung außerhalb des Zeitplans ausführen oder die neuesten Daten abrufen möchten, wählen Sie Jetzt synchronisieren. Dieser Lauf hat keine Auswirkungen auf regelmäßig geplante zukünftige Synchronisierungen. Um eine Synchronisierung automatisch zu starten, wenn Ihre Daten aktualisiert werden, rufen Sie den Endpunkt Synchronisierung triggern aus Ihrer Pipeline auf.