Integrações de armazenamento de data warehouse
Esta página aborda como usar a Ingestão de Dados na Nuvem (CDI) da Braze para sincronizar dados relevantes com sua integração do Snowflake, Redshift, BigQuery e Databricks.
Configuração de integrações de data warehouse
As integrações de Ingestão de dados na nuvem exigem configurações no lado da Braze e na sua instância de data warehouse. Siga estas etapas para configurar a integração:
- Na sua instância do Snowflake, configure as tabelas ou visualizações que você quer sincronizar com a Braze.
- Crie uma função, um warehouse e um usuário que a Braze autentica com Workload Identity Federation ou com um par de chaves RSA.
- Crie uma nova fonte Snowflake no dashboard da Braze. Para um par de chaves, adicione ao usuário do Snowflake a chave pública fornecida pela Braze. Para Workload Identity Federation, execute a instrução do formulário de credencial em uma planilha do Snowflake.
- Crie uma sincronização no dashboard da Braze, teste a integração e inicie a sincronização.
O guia de início rápido do Snowflake fornece um código de exemplo e mostra as etapas necessárias para criar um pipeline automatizado usando Snowflake Streams e CDI para sincronizar dados com a Braze.
- Confira se o acesso da Braze está permitido às tabelas do Redshift que você quer sincronizar. A Braze se conecta ao Redshift pela internet.
- Na sua instância do Redshift, configure as tabelas ou visualizações que você quer sincronizar com a Braze.
- Crie uma nova fonte e uma sincronização no dashboard da Braze.
- Teste a integração e inicie a sincronização.
A quantidade de linhas processadas por sincronização depende da performance do seu warehouse, da latência da rede e de quantos dados novos correspondem à consulta de sincronização. Use o Histórico de sincronização da integração no dashboard para ver a duração e a contagem de linhas das execuções recentes.
- Crie uma conta de serviço que a Braze acessa por meio de Workload Identity Federation ou de uma chave de conta de serviço e permita o acesso aos projetos e conjuntos de dados do BigQuery que contêm os dados que você quer sincronizar.
- Na sua conta do BigQuery, configure as tabelas ou visualizações que você quer sincronizar com a Braze.
- Crie uma nova fonte e uma sincronização no dashboard da Braze.
- Teste a integração e inicie a sincronização.
- Crie uma entidade de serviço para autenticação OAuth máquina a máquina (M2M) ou um token de acesso pessoal e permita o acesso aos catálogos e esquemas do Databricks que contêm os dados que você quer sincronizar.
- Na sua conta do Databricks, configure as tabelas ou visualizações que você quer sincronizar com a Braze.
- Crie uma nova fonte e uma sincronização no dashboard da Braze.
- Teste a integração e inicie a sincronização.
Pode haver de dois a cinco minutos de aquecimento quando a Braze se conecta a instâncias SQL Classic e Pro, o que pode causar atrasos durante a configuração e o teste da conexão, além do início das sincronizações agendadas. Usar uma instância SQL serverless minimiza o tempo de aquecimento e melhora a taxa de processamento de consultas, mas pode resultar em custos de integração um pouco mais altos.
- Crie uma entidade de serviço e conceda acesso às APIs do Fabric.
- Configure um espaço de trabalho compartilhado e conceda à entidade de serviço acesso a ele.
- No espaço de trabalho compartilhado do Fabric, configure as tabelas ou visualizações que você quer sincronizar com a Braze.
- Crie uma nova fonte e uma sincronização no dashboard da Braze.
- Teste a integração e inicie a sincronização.
Etapa 1: Configurar tabelas ou visualizações
As etapas desta seção criam uma tabela com uma coluna PAYLOAD. Se você planeja mapear colunas com Visual ou escrever uma consulta com SQL na etapa Definição de dados, pode usar uma tabela ou visualização existente. Nesse caso, pule a etapa de criação de tabela do seu warehouse e conceda à Braze acesso de leitura às tabelas ou visualizações que você quer sincronizar. Para comparar as opções, consulte Escolher uma opção de definição de dados.
Se você usar uma coluna PAYLOAD, sua tabela ou visualização de origem pode incluir colunas que não estão listadas para o seu warehouse nas guias da seção a seguir (por exemplo, colunas de auditoria ou hashing). A Braze lê apenas as colunas descritas nessas guias. As outras colunas não são usadas durante as sincronizações da Ingestão de dados na nuvem.
Etapa 1.1: Configurar a tabela
CREATE DATABASE BRAZE_CLOUD_PRODUCTION;
CREATE SCHEMA BRAZE_CLOUD_PRODUCTION.INGESTION;
CREATE OR REPLACE TABLE BRAZE_CLOUD_PRODUCTION.INGESTION.USERS_ATTRIBUTES_SYNC (
UPDATED_AT TIMESTAMP_NTZ(9) NOT NULL DEFAULT SYSDATE(),
--at least one of external_id, alias_name and alias_label, email, phone, or braze_id is required
EXTERNAL_ID VARCHAR(16777216),
--if using user alias, both alias_name and alias_label are required
ALIAS_LABEL VARCHAR(16777216),
ALIAS_NAME VARCHAR(16777216),
--braze_id can only be used to update existing users created through the Braze SDK
BRAZE_ID VARCHAR(16777216),
--If you include both email and phone, email is used as the primary identifier
EMAIL VARCHAR(16777216),
PHONE VARCHAR(16777216),
PAYLOAD VARCHAR(16777216) NOT NULL
);
Você pode dar o nome que quiser ao banco de dados, ao esquema e à tabela, mas os nomes das colunas devem corresponder à definição anterior.
UPDATED_AT- O momento em que essa linha foi atualizada ou adicionada à tabela. A Braze sincroniza as linhas em queUPDATED_ATé posterior ao último valor sincronizado. Linhas com o carimbo de data/hora exatamente no limite podem ser sincronizadas novamente se novas linhas compartilharem esse mesmo carimbo de data/hora.- Colunas de identificador de usuário - Sua tabela pode conter uma ou mais colunas de identificador de usuário. Cada linha deve conter apenas um identificador (
external_id, a combinação dealias_nameealias_label,braze_id,emailouphone). Uma tabela de origem pode ter colunas para um, dois, três, quatro ou todos os cinco tipos de identificador.EXTERNAL_ID- Identifica o usuário que você quer atualizar. Deve corresponder ao valor deexternal_idusado na Braze.ALIAS_NAMEeALIAS_LABEL- Essas duas colunas criam um objeto de alias de usuário.alias_namedeve ser um identificador único, ealias_labelespecifica o tipo de alias. Os usuários podem ter vários aliases com rótulos diferentes, mas apenas umalias_nameporalias_label.BRAZE_ID- O identificador de usuário da Braze. Ele é gerado pelo SDK da Braze, e não é possível criar novos usuários usando um ID da Braze por meio da Ingestão de dados na nuvem. Para criar novos usuários, especifique um ID de usuário externo ou um alias de usuário.EMAIL- O endereço de e-mail do usuário. Se houver vários perfis com o mesmo endereço de e-mail, o perfil atualizado mais recentemente terá prioridade nas atualizações. Se você incluir e-mail e telefone, o e-mail será usado como identificador principal.PHONE- O número de telefone do usuário. Se houver vários perfis com o mesmo número de telefone, o perfil atualizado mais recentemente terá prioridade nas atualizações.
PAYLOAD- Uma string JSON com os campos que você quer sincronizar com o usuário na Braze.
Etapa 1.2: Configurar a função e as permissões do banco de dados
CREATE ROLE BRAZE_INGESTION_ROLE;
GRANT USAGE ON DATABASE BRAZE_CLOUD_PRODUCTION TO ROLE BRAZE_INGESTION_ROLE;
GRANT USAGE ON SCHEMA BRAZE_CLOUD_PRODUCTION.INGESTION TO ROLE BRAZE_INGESTION_ROLE;
GRANT SELECT ON TABLE BRAZE_CLOUD_PRODUCTION.INGESTION.USERS_ATTRIBUTES_SYNC TO ROLE BRAZE_INGESTION_ROLE;
Atualize os nomes conforme necessário, mas as permissões devem corresponder ao exemplo anterior.
Etapa 1.3: Configurar o warehouse e dar acesso à função da Braze
CREATE WAREHOUSE BRAZE_INGESTION_WAREHOUSE;
GRANT USAGE ON WAREHOUSE BRAZE_INGESTION_WAREHOUSE TO ROLE BRAZE_INGESTION_ROLE;
O warehouse precisa estar com a flag auto-resume ativada. Caso contrário, conceda à Braze privilégios OPERATE adicionais no warehouse para que a Braze possa ativá-lo quando a consulta for executada.
Etapa 1.4: Configurar o usuário
A Braze se autentica no Snowflake com um dos seguintes métodos:
- Workload Identity Federation: A Braze se conecta como um usuário
TYPE = SERVICEvinculado à identidade AWS da Braze para o Snowflake. O usuário não tem senha nem chave RSA. - Par de chaves: A Braze se conecta com um par de chaves RSA. Você adiciona ao usuário do Snowflake a chave pública gerada pela Braze.
As credenciais de par de chaves RSA existentes continuam funcionando, e você não precisa migrá-las. Siga um dos métodos.
Crie a função, o warehouse e as concessões do banco de dados na Etapa 1.2 e na Etapa 1.3. Se a sua conta do Snowflake usar uma política de rede, permita os endereços IP da Braze conforme descrito na Etapa 1.5.
Crie o usuário de serviço a partir do formulário de credencial do Snowflake e execute essa instrução em uma planilha do Snowflake. Para saber o que a instrução faz e onde executá-la, consulte Configuração do Snowflake para Workload Identity Federation.
CREATE USER BRAZE_INGESTION_USER;
GRANT ROLE BRAZE_INGESTION_ROLE TO USER BRAZE_INGESTION_USER;
Depois desta etapa, compartilhe as informações de conexão com a Braze e adicione a chave pública ao usuário.
Ao conectar espaços de trabalho diferentes à mesma conta do Snowflake, você deve criar um usuário exclusivo para cada espaço de trabalho da Braze em que estiver criando uma integração. Dentro de um espaço de trabalho, você pode reutilizar o mesmo usuário em várias integrações, mas a criação da integração falha se um usuário da mesma conta do Snowflake for duplicado entre espaços de trabalho.
Etapa 1.5: Permitir IPs da Braze na política de rede do Snowflake (opcional)
Dependendo da configuração da sua conta do Snowflake, pode ser necessário permitir os seguintes endereços IP na sua política de rede do Snowflake. Para saber mais sobre como ativar isso, consulte a documentação do Snowflake sobre como modificar uma política de rede.
Para as instâncias US-01, US-02, US-03, US-04, US-05, US-06, US-07, estes são os endereços IP relevantes:
23.21.118.19134.206.23.17350.16.249.952.4.160.21454.87.8.3454.156.35.25152.54.89.23818.205.178.15
Para a instância US-08, estes são os endereços IP relevantes:
52.151.246.5152.170.163.18240.76.166.15740.76.166.17040.76.166.16740.76.166.16140.76.166.15640.76.166.16640.76.166.16040.88.51.7452.154.67.1740.76.166.8040.76.166.8440.76.166.8540.76.166.8140.76.166.7140.76.166.14440.76.166.145
Para a instância US-10, estes são os endereços IP relevantes:
100.25.232.16435.168.86.17952.7.44.1173.92.153.1835.172.3.12950.19.162.19
Para as instâncias EU-01 e EU-02, estes são os endereços IP relevantes:
52.58.142.24252.29.193.12135.158.29.22818.157.135.973.123.166.463.64.27.363.65.88.253.68.144.1883.70.107.88
Para a instância AU-01, estes são os endereços IP relevantes:
13.210.1.14513.211.70.15913.238.45.5452.65.73.16754.153.242.23954.206.45.213
Para a instância ID-01, estes são os endereços IP relevantes:
108.136.157.246108.137.30.20716.78.128.7116.78.14.13416.78.162.20843.218.73.35
Para a instância JP-01, estes são os endereços IP relevantes:
13.159.155.21254.199.221.24113.192.23.1654.250.120.13918.181.114.2323.114.38.100
Para a instância KR-01, estes são os endereços IP relevantes:
43.200.215.452.79.67.17552.79.113.603.34.212.9254.116.134.2313.37.197.225
Etapa 1.1: Configurar a tabela
Opcionalmente, configure um novo banco de dados e um novo esquema para armazenar sua tabela de origem
CREATE DATABASE BRAZE_CLOUD_PRODUCTION;
CREATE SCHEMA BRAZE_CLOUD_PRODUCTION.INGESTION;
Crie uma tabela (ou visualização) para usar na sua integração de CDI
CREATE TABLE BRAZE_CLOUD_PRODUCTION.INGESTION.USERS_ATTRIBUTES_SYNC (
updated_at timestamptz default sysdate,
--at least one of external_id, alias_name and alias_label, or braze_id is required
external_id varchar,
--if using user alias, both alias_name and alias_label are required
alias_label varchar,
alias_name varchar,
--braze_id can only be used to update existing users created through the Braze SDK
braze_id varchar,
--If you include both email and phone, email is used as the primary identifier
email varchar,
phone varchar,
payload varchar(max)
)
Você pode dar o nome que quiser ao banco de dados, ao esquema e à tabela, mas os nomes das colunas devem corresponder à definição anterior.
UPDATED_AT- O momento em que essa linha foi atualizada ou adicionada à tabela. A Braze sincroniza as linhas em queUPDATED_ATé posterior ao último valor sincronizado. Linhas com o carimbo de data/hora exatamente no limite podem ser sincronizadas novamente se novas linhas compartilharem esse mesmo carimbo de data/hora.- Colunas de identificador de usuário - Sua tabela pode conter uma ou mais colunas de identificador de usuário. Cada linha deve conter apenas um identificador (
external_id, a combinação dealias_nameealias_label,braze_id,emailouphone). Uma tabela de origem pode ter colunas para um, dois, três, quatro ou todos os cinco tipos de identificador.EXTERNAL_ID- Identifica o usuário que você quer atualizar. Deve corresponder ao valor deexternal_idusado na Braze.ALIAS_NAMEeALIAS_LABEL- Essas duas colunas criam um objeto de alias de usuário.alias_namedeve ser um identificador único, ealias_labelespecifica o tipo de alias. Os usuários podem ter vários aliases com rótulos diferentes, mas apenas umalias_nameporalias_label.BRAZE_ID- O identificador de usuário da Braze. Ele é gerado pelo SDK da Braze, e não é possível criar novos usuários usando um ID da Braze por meio da Ingestão de dados na nuvem. Para criar novos usuários, especifique um ID de usuário externo ou um alias de usuário.EMAIL- O endereço de e-mail do usuário. Se houver vários perfis com o mesmo endereço de e-mail, o perfil atualizado mais recentemente terá prioridade nas atualizações. Se você incluir e-mail e telefone, o e-mail será usado como identificador principal.PHONE- O número de telefone do usuário. Se houver vários perfis com o mesmo número de telefone, o perfil atualizado mais recentemente terá prioridade nas atualizações.
PAYLOAD- Uma string JSON com os campos que você quer sincronizar com o usuário na Braze.
Etapa 1.2: Criar usuário e conceder permissões
CREATE USER braze_user PASSWORD '{password}';
GRANT USAGE ON SCHEMA BRAZE_CLOUD_PRODUCTION.INGESTION to braze_user;
GRANT SELECT ON TABLE USERS_ATTRIBUTES_SYNC TO braze_user;
Essas são as permissões mínimas necessárias para esse usuário. Se você for criar várias integrações de CDI, talvez seja melhor conceder permissões a um esquema ou gerenciar as permissões usando um grupo.
Etapa 1.3: Permitir acesso aos IPs da Braze
Se você tiver um firewall ou outras políticas de rede, deve dar à Braze acesso de rede à sua instância do Redshift. Um exemplo de endpoint de URL do Redshift é “example-cluster.ap-northeast-2.redshift.amazonaws.com”.
Alguns pontos importantes:
- Talvez você também precise alterar seus grupos de segurança para permitir que a Braze acesse seus dados no Redshift.
- Permita explicitamente o tráfego de entrada nos IPs da tabela e na porta usada para consultar seu cluster do Redshift (o padrão é 5439). Você deve permitir explicitamente a conectividade TCP do Redshift nessa porta, mesmo que as regras de entrada estejam definidas como “permitir tudo”.
- O endpoint do cluster do Redshift deve estar acessível publicamente para que a Braze se conecte ao seu cluster.
- Se você não quiser que seu cluster do Redshift fique acessível publicamente, pode configurar uma VPC e uma instância EC2 para usar um túnel SSH e acessar os dados do Redshift. Para saber mais, consulte a publicação do AWS Knowledge Center.
Permita o acesso a partir dos seguintes IPs correspondentes à região do seu dashboard da Braze.
Para as instâncias US-01, US-02, US-03, US-04, US-05, US-06, US-07, estes são os endereços IP relevantes:
23.21.118.19134.206.23.17350.16.249.952.4.160.21454.87.8.3454.156.35.25152.54.89.23818.205.178.15
Para a instância US-08, estes são os endereços IP relevantes:
52.151.246.5152.170.163.18240.76.166.15740.76.166.17040.76.166.16740.76.166.16140.76.166.15640.76.166.16640.76.166.16040.88.51.7452.154.67.1740.76.166.8040.76.166.8440.76.166.8540.76.166.8140.76.166.7140.76.166.14440.76.166.145
Para a instância US-10, estes são os endereços IP relevantes:
100.25.232.16435.168.86.17952.7.44.1173.92.153.1835.172.3.12950.19.162.19
Para as instâncias EU-01 e EU-02, estes são os endereços IP relevantes:
52.58.142.24252.29.193.12135.158.29.22818.157.135.973.123.166.463.64.27.363.65.88.253.68.144.1883.70.107.88
Para a instância AU-01, estes são os endereços IP relevantes:
13.210.1.14513.211.70.15913.238.45.5452.65.73.16754.153.242.23954.206.45.213
Para a instância ID-01, estes são os endereços IP relevantes:
108.136.157.246108.137.30.20716.78.128.7116.78.14.13416.78.162.20843.218.73.35
Para a instância JP-01, estes são os endereços IP relevantes:
13.159.155.21254.199.221.24113.192.23.1654.250.120.13918.181.114.2323.114.38.100
Para a instância KR-01, estes são os endereços IP relevantes:
43.200.215.452.79.67.17552.79.113.603.34.212.9254.116.134.2313.37.197.225
Etapa 1.1: Configurar a tabela
Opcionalmente, configure um novo projeto ou conjunto de dados para armazenar sua tabela de origem.
CREATE SCHEMA BRAZE-CLOUD-PRODUCTION.INGESTION;
Crie uma ou mais tabelas para usar na sua integração de CDI com os seguintes campos:
CREATE TABLE `BRAZE-CLOUD-PRODUCTION.INGESTION.USERS_ATTRIBUTES_SYNC`
(
updated_at TIMESTAMP DEFAULT current_timestamp,
--At least one of external_id, alias_name and alias_label, or braze_id is required
external_id STRING,
--If using user alias, both alias_name and alias_label are required
alias_name STRING,
alias_label STRING,
--braze_id can only be used to update existing users created through the Braze SDK
braze_id STRING,
--If you include both email and phone, email is used as the primary identifier
email STRING,
phone STRING,
payload JSON
);
| Nome do campo | Tipo | Modo |
|---|---|---|
UPDATED_AT |
TIMESTAMP | REQUIRED |
PAYLOAD |
JSON | REQUIRED |
EXTERNAL_ID |
STRING | NULLABLE |
ALIAS_NAME |
STRING | NULLABLE |
ALIAS_LABEL |
STRING | NULLABLE |
BRAZE_ID |
STRING | NULLABLE |
EMAIL |
STRING | NULLABLE |
PHONE |
STRING | NULLABLE |
Você pode dar o nome que quiser ao projeto, ao conjunto de dados e à tabela, mas os nomes das colunas devem corresponder à definição anterior.
UPDATED_AT- O momento em que essa linha foi atualizada ou adicionada à tabela. A Braze sincroniza as linhas em queUPDATED_ATé posterior ao último valor sincronizado. Linhas com o carimbo de data/hora exatamente no limite podem ser sincronizadas novamente se novas linhas compartilharem esse mesmo carimbo de data/hora.- Colunas de identificador de usuário - Sua tabela pode conter uma ou mais colunas de identificador de usuário. Cada linha deve conter apenas um identificador (
external_id, a combinação dealias_nameealias_label,braze_id,emailouphone). Uma tabela de origem pode ter colunas para um, dois, três, quatro ou todos os cinco tipos de identificador.EXTERNAL_ID- Identifica o usuário que você quer atualizar. Deve corresponder ao valor deexternal_idusado na Braze.ALIAS_NAMEeALIAS_LABEL- Essas duas colunas criam um objeto de alias de usuário.alias_namedeve ser um identificador único, ealias_labelespecifica o tipo de alias. Os usuários podem ter vários aliases com rótulos diferentes, mas apenas umalias_nameporalias_label.BRAZE_ID- O identificador de usuário da Braze. Ele é gerado pelo SDK da Braze, e não é possível criar novos usuários usando um ID da Braze por meio da Ingestão de dados na nuvem. Para criar novos usuários, especifique um ID de usuário externo ou um alias de usuário.EMAIL- O endereço de e-mail do usuário. Se houver vários perfis com o mesmo endereço de e-mail, o perfil atualizado mais recentemente terá prioridade nas atualizações. Se você incluir e-mail e telefone, o e-mail será usado como identificador principal.PHONE- O número de telefone do usuário. Se houver vários perfis com o mesmo número de telefone, o perfil atualizado mais recentemente terá prioridade nas atualizações.
PAYLOAD- Uma string JSON com os campos que você quer sincronizar com o usuário na Braze.
Particionamento do BigQuery
A CDI oferece suporte a partições no BigQuery. Se você particionar por uma função de UPDATED_AT (por exemplo, com granularidade de dia, semana ou hora, dependendo do tamanho do seu conjunto de dados), o BigQuery pode reduzir os dados que precisa varrer. Isso melhora a performance e a eficiência em tabelas muito grandes.
Não particione por nenhum outro campo. Teste diferentes configurações para encontrar a melhor para os seus dados.
Todas as consultas da CDI filtram por UPDATED_AT, mas esse comportamento pode mudar. Projete o esquema da sua tabela para não exigir que as consultas incluam essa cláusula.
Para saber mais, consulte a documentação de particionamento do BigQuery.
Etapa 1.2: Criar credenciais para a Braze
Crie uma conta de serviço no GCP para que a Braze a use para se conectar e ler dados da(s) sua(s) tabela(s). A conta de serviço deve ter as seguintes permissões:
- BigQuery Connection User: Permite que a Braze faça conexões.
- BigQuery User: Dá à Braze acesso para executar consultas, ler metadados de conjuntos de dados e listar tabelas.
- BigQuery Data Viewer: Dá à Braze acesso para visualizar conjuntos de dados e seu conteúdo.
- BigQuery Job User: Dá à Braze acesso para executar jobs.
A Braze pode acessar a conta de serviço com um dos seguintes métodos de autenticação:
- Workload Identity Federation: A Braze assume a identidade da conta de serviço com uma identidade de curta duração, então você não precisa criar nem fazer upload de uma chave.
- Chave da conta de serviço: Você faz upload de uma chave JSON da conta de serviço para a Braze.
As credenciais de chave de conta de serviço existentes continuam funcionando, e você não precisa migrá-las. Uma única credencial de Workload Identity Federation pode atender fontes do BigQuery e do Google Cloud Storage.
Configure um pool de identidade de carga de trabalho, um provedor e a conta de serviço, e vincule o principal da Braze à conta de serviço. Para ver as etapas, consulte Configuração do Google Cloud para Workload Identity Federation. Se você já configurou o Workload Identity Federation para uma fonte do Google Cloud Storage, não precisa repetir o processo. Conceda à conta de serviço existente as permissões listadas nesta etapa.
Depois de criar a conta de serviço e conceder as permissões, gere uma chave JSON. Para saber mais, consulte Criar e excluir chaves de contas de serviço. Você fará upload dessa chave no dashboard da Braze em uma etapa posterior.
Etapa 1.3: Permitir acesso aos IPs da Braze
Se você tiver políticas de rede em vigor, deve dar à Braze acesso de rede à sua instância do BigQuery. Permita o acesso a partir dos seguintes IPs correspondentes à região do seu dashboard da Braze.
Para as instâncias US-01, US-02, US-03, US-04, US-05, US-06, US-07, estes são os endereços IP relevantes:
23.21.118.19134.206.23.17350.16.249.952.4.160.21454.87.8.3454.156.35.25152.54.89.23818.205.178.15
Para a instância US-08, estes são os endereços IP relevantes:
52.151.246.5152.170.163.18240.76.166.15740.76.166.17040.76.166.16740.76.166.16140.76.166.15640.76.166.16640.76.166.16040.88.51.7452.154.67.1740.76.166.8040.76.166.8440.76.166.8540.76.166.8140.76.166.7140.76.166.14440.76.166.145
Para a instância US-10, estes são os endereços IP relevantes:
100.25.232.16435.168.86.17952.7.44.1173.92.153.1835.172.3.12950.19.162.19
Para as instâncias EU-01 e EU-02, estes são os endereços IP relevantes:
52.58.142.24252.29.193.12135.158.29.22818.157.135.973.123.166.463.64.27.363.65.88.253.68.144.1883.70.107.88
Para a instância AU-01, estes são os endereços IP relevantes:
13.210.1.14513.211.70.15913.238.45.5452.65.73.16754.153.242.23954.206.45.213
Para a instância ID-01, estes são os endereços IP relevantes:
108.136.157.246108.137.30.20716.78.128.7116.78.14.13416.78.162.20843.218.73.35
Para a instância JP-01, estes são os endereços IP relevantes:
13.159.155.21254.199.221.24113.192.23.1654.250.120.13918.181.114.2323.114.38.100
Para a instância KR-01, estes são os endereços IP relevantes:
43.200.215.452.79.67.17552.79.113.603.34.212.9254.116.134.2313.37.197.225
Etapa 1.1: Configurar a tabela
Opcionalmente, configure um novo catálogo ou esquema para armazenar sua tabela de origem.
CREATE SCHEMA BRAZE-CLOUD-PRODUCTION.INGESTION;
Crie uma ou mais tabelas para usar na sua integração de CDI com os seguintes campos:
CREATE TABLE `BRAZE-CLOUD-PRODUCTION.INGESTION.USERS_ATTRIBUTES_SYNC`
(
updated_at TIMESTAMP DEFAULT current_timestamp(),
--At least one of external_id, alias_name and alias_label, or braze_id is required
external_id STRING,
--If using user alias, both alias_name and alias_label are required
alias_name STRING,
alias_label STRING,
--braze_id can only be used to update existing users created through the Braze SDK
braze_id STRING,
--If you include both email and phone, email is used as the primary identifier
email STRING,
phone STRING,
payload STRING, STRUCT, or MAP
);
| Nome do campo | Tipo | Modo |
|---|---|---|
UPDATED_AT |
TIMESTAMP | REQUIRED |
PAYLOAD |
STRING, STRUCT ou MAP | REQUIRED |
EXTERNAL_ID |
STRING | NULLABLE |
ALIAS_NAME |
STRING | NULLABLE |
ALIAS_LABEL |
STRING | NULLABLE |
BRAZE_ID |
STRING | NULLABLE |
EMAIL |
STRING | NULLABLE |
PHONE |
STRING | NULLABLE |
Você pode dar o nome que quiser ao esquema e à tabela, mas os nomes das colunas devem corresponder à definição anterior.
UPDATED_AT- O momento em que essa linha foi atualizada ou adicionada à tabela. A Braze sincroniza as linhas em queUPDATED_ATé posterior ao último valor sincronizado. Linhas com o carimbo de data/hora exatamente no limite podem ser sincronizadas novamente se novas linhas compartilharem esse mesmo carimbo de data/hora.- Colunas de identificador de usuário - Sua tabela pode conter uma ou mais colunas de identificador de usuário. Cada linha deve conter apenas um identificador (
external_id, a combinação dealias_nameealias_label,braze_id,emailouphone). Uma tabela de origem pode ter colunas para um, dois, três, quatro ou todos os cinco tipos de identificador.EXTERNAL_ID- Identifica o usuário que você quer atualizar. Deve corresponder ao valor deexternal_idusado na Braze.ALIAS_NAMEeALIAS_LABEL- Essas duas colunas criam um objeto de alias de usuário.alias_namedeve ser um identificador único, ealias_labelespecifica o tipo de alias. Os usuários podem ter vários aliases com rótulos diferentes, mas apenas umalias_nameporalias_label.BRAZE_ID- O identificador de usuário da Braze. Ele é gerado pelo SDK da Braze, e não é possível criar novos usuários usando um ID da Braze por meio da Ingestão de dados na nuvem. Para criar novos usuários, especifique um ID de usuário externo ou um alias de usuário.EMAIL- O endereço de e-mail do usuário. Se houver vários perfis com o mesmo endereço de e-mail, o perfil atualizado mais recentemente terá prioridade nas atualizações. Se você incluir e-mail e telefone, o e-mail será usado como identificador principal.PHONE- O número de telefone do usuário. Se houver vários perfis com o mesmo número de telefone, o perfil atualizado mais recentemente terá prioridade nas atualizações.
PAYLOAD- Uma string ou struct com os campos que você quer sincronizar com o usuário na Braze.
Etapa 1.2: Criar credenciais para a Braze
A Braze pode se conectar ao Databricks com um dos seguintes métodos de autenticação:
- OAuth M2M (recomendado): A Braze se autentica como uma entidade de serviço do Databricks usando um ID do cliente e um segredo do cliente. O Databricks recomenda a autenticação OAuth M2M para conexões não supervisionadas, como a Ingestão de dados na nuvem.
- Token de acesso pessoal: A Braze se autentica com um token gerado no seu espaço de trabalho do Databricks.
As credenciais de token de acesso pessoal existentes continuam funcionando, e você não precisa migrá-las. No entanto, os tokens de acesso pessoal costumam expirar de acordo com um cronograma definido pelo administrador do seu espaço de trabalho, e as sincronizações param quando o token expira. Para migrar uma fonte existente para OAuth M2M, crie uma credencial OAuth M2M e selecione-a ao editar a fonte.
A Braze se conecta ao seu espaço de trabalho do Databricks usando uma entidade de serviço com autenticação OAuth M2M. Crie uma nova entidade de serviço para a Braze usar e conceda a ela acesso ao seu SQL warehouse e às tabelas de origem. A Braze precisa das seguintes informações para se conectar:
- ID do cliente (também chamado de ID do aplicativo) da entidade de serviço
- Segredo do cliente para a Braze se autenticar
Criar a entidade de serviço
- No seu espaço de trabalho do Databricks, selecione seu nome de usuário na barra superior e, em seguida, selecione Settings.
- Acesse Identity and access e selecione Manage ao lado de Service principals.
- Selecione Add service principal > Add new.
- Insira um nome que ajude você a identificar a entidade de serviço, como “Braze CDI”, e selecione Add.
- Selecione a entidade de serviço que você criou. Na guia Configurations, confira se Databricks SQL access está selecionado.
Gerar um segredo do cliente
- Na página da entidade de serviço, selecione a guia Secrets e, em seguida, selecione Generate secret.
- Insira a vida útil do segredo, em dias. O Databricks permite uma vida útil máxima de 730 dias.
- Selecione Generate.
- Copie os valores de Secret e Client ID e selecione Done.
Guarde o ID do cliente e o segredo em um local seguro até precisar inseri-los no dashboard da Braze, durante a etapa de criação da credencial. O Databricks mostra o segredo apenas uma vez.
O Databricks não permite vida útil ilimitada para segredos de entidades de serviço. Lembre-se de substituir o segredo antes que ele expire para manter o fluxo de dados para a Braze. Para ver as etapas, consulte Atualizar o segredo do cliente.
Conceder acesso ao SQL warehouse
A Braze precisa de permissão para executar consultas no seu SQL warehouse, mas não precisa de acesso de administrador do espaço de trabalho.
- Na barra lateral, selecione SQL Warehouses e, em seguida, selecione o warehouse que você quer que a Braze use.
- Selecione Permissions.
- Pesquise e selecione a entidade de serviço que você criou.
- No menu suspenso de permissão, selecione Can use e, em seguida, selecione Add.
Conceder acesso às tabelas de origem
Conceda à entidade de serviço acesso de leitura ao catálogo, ao esquema e às tabelas que você configurou na Etapa 1.1. Use o ID do aplicativo da entidade de serviço (o mesmo valor do ID do cliente) como beneficiário da concessão.
GRANT USE CATALOG ON CATALOG `BRAZE-CLOUD-PRODUCTION` TO `APPLICATION_ID`;
GRANT USE SCHEMA ON SCHEMA `BRAZE-CLOUD-PRODUCTION`.INGESTION TO `APPLICATION_ID`;
GRANT SELECT ON TABLE `BRAZE-CLOUD-PRODUCTION`.INGESTION.USERS_ATTRIBUTES_SYNC TO `APPLICATION_ID`;
Substitua APPLICATION_ID pelo ID do aplicativo da sua entidade de serviço. Atualize os outros nomes conforme necessário, mas as permissões devem corresponder ao exemplo anterior.
Atualizar o segredo do cliente
A Braze armazena um segredo do cliente por credencial. Quando você o atualiza, todas as fontes e sincronizações que usam a credencial passam a usar o novo segredo. Para substituir o segredo:
- No Databricks, gere um novo segredo para a entidade de serviço seguindo as etapas em Gerar um segredo do cliente. Mantenha o segredo antigo até a etapa 6.
- No dashboard da Braze, acesse Configurações de dados > Ingestão de dados na nuvem > Credenciais e selecione sua credencial OAuth M2M. A seção Usado por lista todas as fontes e sincronizações que usam essa credencial.
- Pause as sincronizações que usam essa credencial ou planeje a atualização para um horário em que nenhuma delas esteja agendada para ser executada. Isso evita que uma sincronização seja iniciada enquanto você atualiza a credencial.
- Selecione Editar credencial, insira o novo segredo do cliente e selecione Salvar. A alteração se aplica a todas as fontes e sincronizações que usam essa credencial.
- Retome as sincronizações que você pausou.
- Depois que a Braze salvar o novo segredo, exclua o segredo antigo no Databricks.
Para que a Braze acesse o Databricks, é necessário criar um token de acesso pessoal.
- No seu espaço de trabalho do Databricks, selecione seu nome de usuário do Databricks na barra superior e, em seguida, selecione User Settings no menu suspenso.
- Na guia Access tokens, selecione Generate new token.
- Insira um comentário que ajude você a identificar esse token, como “Braze CDI”, e altere a vida útil do token para sem vencimento, deixando a caixa Lifetime (days) vazia (em branco).
- Selecione Generate.
- Copie o token exibido e selecione Done.
Guarde o token em um local seguro até precisar inseri-lo no dashboard da Braze, durante a etapa de criação da credencial.
Etapa 1.3: Permitir acesso aos IPs da Braze
Se você tiver políticas de rede em vigor, deve dar à Braze acesso de rede à sua instância do Databricks. Permita o acesso a partir dos seguintes IPs correspondentes à região do seu dashboard da Braze.
Para as instâncias US-01, US-02, US-03, US-04, US-05, US-06, US-07, estes são os endereços IP relevantes:
23.21.118.19134.206.23.17350.16.249.952.4.160.21454.87.8.3454.156.35.25152.54.89.23818.205.178.15
Para a instância US-08, estes são os endereços IP relevantes:
52.151.246.5152.170.163.18240.76.166.15740.76.166.17040.76.166.16740.76.166.16140.76.166.15640.76.166.16640.76.166.16040.88.51.7452.154.67.1740.76.166.8040.76.166.8440.76.166.8540.76.166.8140.76.166.7140.76.166.14440.76.166.145
Para a instância US-10, estes são os endereços IP relevantes:
100.25.232.16435.168.86.17952.7.44.1173.92.153.1835.172.3.12950.19.162.19
Para as instâncias EU-01 e EU-02, estes são os endereços IP relevantes:
52.58.142.24252.29.193.12135.158.29.22818.157.135.973.123.166.463.64.27.363.65.88.253.68.144.1883.70.107.88
Para a instância AU-01, estes são os endereços IP relevantes:
13.210.1.14513.211.70.15913.238.45.5452.65.73.16754.153.242.23954.206.45.213
Para a instância ID-01, estes são os endereços IP relevantes:
108.136.157.246108.137.30.20716.78.128.7116.78.14.13416.78.162.20843.218.73.35
Para a instância JP-01, estes são os endereços IP relevantes:
13.159.155.21254.199.221.24113.192.23.1654.250.120.13918.181.114.2323.114.38.100
Para a instância KR-01, estes são os endereços IP relevantes:
43.200.215.452.79.67.17552.79.113.603.34.212.9254.116.134.2313.37.197.225
Etapa 1.1: Configurar a entidade de serviço e conceder acesso
A Braze se conecta ao seu warehouse do Fabric usando uma entidade de serviço com autenticação do Entra ID. Crie uma nova entidade de serviço para a Braze usar e conceda acesso aos recursos do Fabric conforme necessário. A Braze precisa das seguintes informações para se conectar:
- ID do locatário (também chamado de diretório) da sua conta Azure
- ID da entidade de segurança (também chamado de ID do aplicativo) para a entidade de serviço
- Segredo do cliente para a Braze autenticar
- No portal do Azure, navegue até o centro de administração do Microsoft Entra e, em seguida, App Registrations.
- Selecione + New registration em Identity > Applications > App registrations
- Insira um nome e selecione
Accounts in this organizational directory onlycomo o tipo de conta compatível. Em seguida, selecione Register. - Selecione o app (service principal) que você acabou de criar e navegue até Certificates & secrets > + New client secret
- Insira uma descrição para o segredo e defina um período de vencimento para o segredo. Em seguida, selecione Add.
- Anote o segredo do cliente criado para usar na configuração da Braze.
O Azure não permite vencimento ilimitado para segredos de entidades de serviço. Lembre-se de renovar as credenciais antes que elas expirem para manter o fluxo de dados para a Braze.
Etapa 1.2: Conceder acesso aos recursos do Fabric
Dê à Braze acesso para se conectar à sua instância do Fabric. No portal de administração do Fabric, acesse Settings > Governance and insights > Admin portal > Tenant settings.
- Em Developer settings, ative Service principals can use Fabric APIs para que a Braze possa se conectar usando o Microsoft Entra ID.
- Em OneLake settings, ative Users can access data stored in OneLake with apps external to Fabric para que a entidade de serviço possa acessar dados a partir de um app externo.
Etapa 1.3: Configurar um espaço de trabalho compartilhado e conceder acesso
Todos os recursos do Fabric que você quer conectar à Braze devem estar em um espaço de trabalho compartilhado. Se você usava apenas o My Workspace padrão, crie um novo espaço de trabalho compartilhado:
- No menu de navegação, selecione Workspaces e, em seguida, selecione + New workspace.
- Insira um Name para o espaço de trabalho e selecione Apply.
Depois de ter um espaço de trabalho compartilhado, conceda acesso à entidade de serviço:
- Selecione o espaço de trabalho e, em seguida, selecione Manage Access.
- Selecione + Add people or groups.
- Pesquise e selecione o nome da entidade de serviço que você criou na Etapa 1.1. Se ela não aparecer, confirme se você ativou a configuração Service principals can use Fabric APIs na Etapa 1.2.
- No menu suspenso de função, selecione Contributor.
Agora a entidade de serviço pode acessar os recursos de warehouse do Fabric nesse espaço de trabalho por meio dos endpoints SQL, incluindo o warehouse a ser usado com a Braze.
Etapa 1.4: Configurar a tabela
A Braze oferece suporte a tabelas e visualizações em warehouses do Fabric. Se precisar criar um novo warehouse, crie-o dentro do espaço de trabalho compartilhado da Etapa 1.3. Acesse Create > Data Warehouse > Warehouse no console do Fabric.
CREATE OR ALTER TABLE [warehouse].[schema].[CDI_table_name]
(
UPDATED_AT DATETIME2(6) NOT NULL,
PAYLOAD VARCHAR NOT NULL,
--at least one of external_id, alias_name and alias_label, email, phone, or braze_id is required
EXTERNAL_ID VARCHAR,
--if using user alias, both alias_name and alias_label are required
ALIAS_NAME VARCHAR,
ALIAS_LABEL VARCHAR,
--braze_id can only be used to update existing users created through the Braze SDK
BRAZE_ID VARCHAR,
--If you include both email and phone, email is used as the primary identifier
EMAIL VARCHAR,
PHONE VARCHAR
)
GO
Você pode dar o nome que quiser ao warehouse, ao esquema e à tabela ou visualização, mas os nomes das colunas devem corresponder à definição anterior.
UPDATED_AT- O momento em que essa linha foi atualizada ou adicionada à tabela. A Braze sincroniza as linhas em queUPDATED_ATé posterior ao último valor sincronizado. Linhas com o carimbo de data/hora exatamente no limite podem ser sincronizadas novamente se novas linhas compartilharem esse mesmo carimbo de data/hora.- Colunas de identificador de usuário - Sua tabela pode conter uma ou mais colunas de identificador de usuário. Cada linha deve conter apenas um identificador (
external_id, a combinação dealias_nameealias_label,braze_id,emailouphone). Uma tabela de origem pode ter colunas para um, dois, três, quatro ou todos os cinco tipos de identificador.EXTERNAL_ID- Identifica o usuário que você quer atualizar. Deve corresponder ao valor deexternal_idusado na Braze.ALIAS_NAMEeALIAS_LABEL- Essas duas colunas criam um objeto de alias de usuário.alias_namedeve ser um identificador único, ealias_labelespecifica o tipo de alias. Os usuários podem ter vários aliases com rótulos diferentes, mas apenas umalias_nameporalias_label.BRAZE_ID- O identificador de usuário da Braze. Ele é gerado pelo SDK da Braze, e não é possível criar novos usuários usando um ID da Braze por meio da Ingestão de dados na nuvem. Para criar novos usuários, especifique um ID de usuário externo ou um alias de usuário.EMAIL- O endereço de e-mail do usuário. Se houver vários perfis com o mesmo endereço de e-mail, o perfil atualizado mais recentemente terá prioridade nas atualizações. Se você incluir e-mail e telefone, o e-mail será usado como identificador principal.PHONE- O número de telefone do usuário. Se houver vários perfis com o mesmo número de telefone, o perfil atualizado mais recentemente terá prioridade nas atualizações.
PAYLOAD- Uma string JSON com os campos que você quer sincronizar com o usuário na Braze.
Etapa 1.5: Obter a string de conexão do warehouse
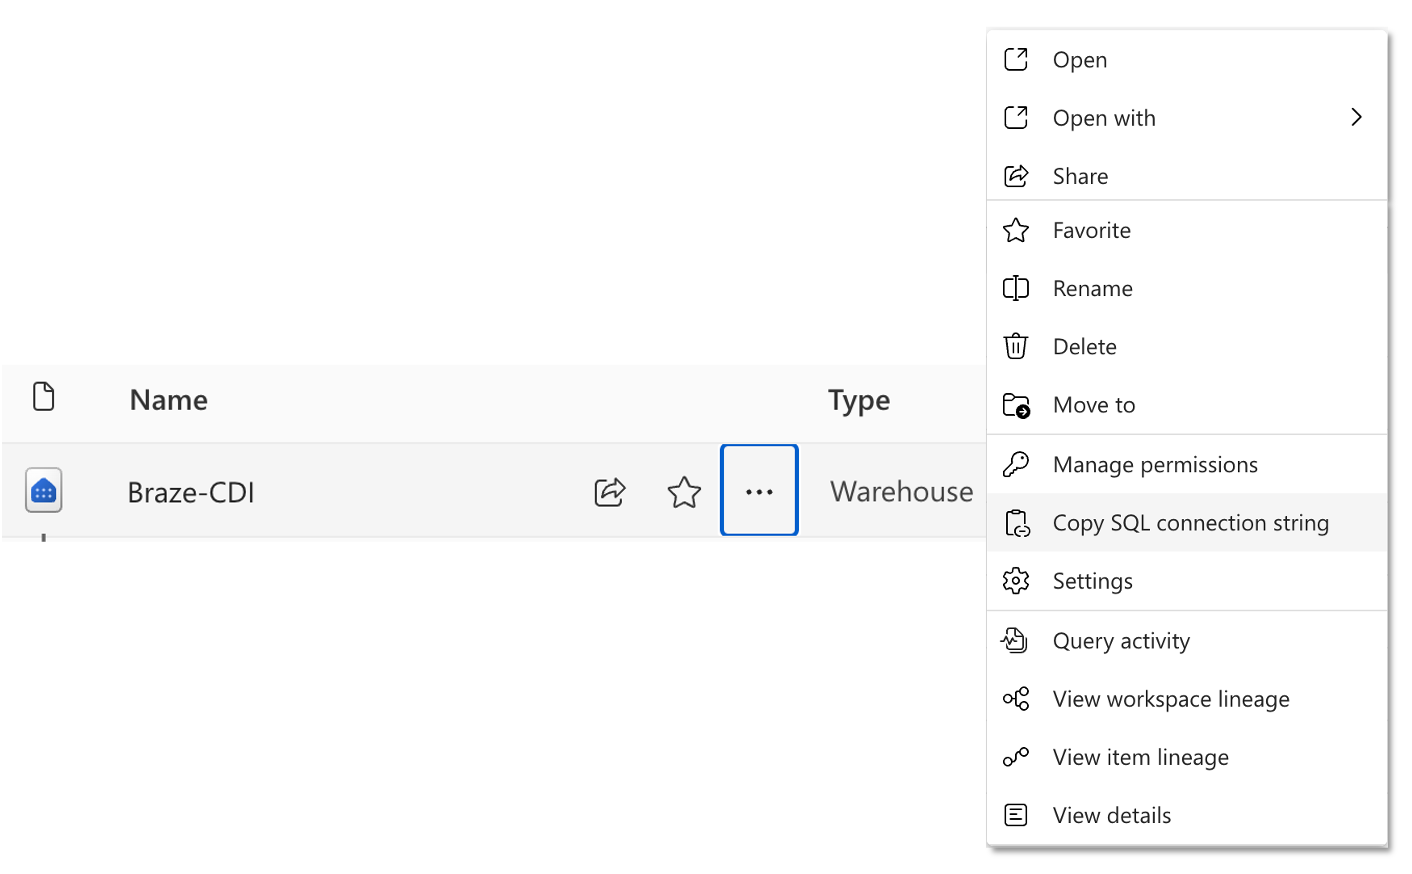
Para obter o endpoint SQL do seu warehouse, acesse o workspace no Fabric, passe o mouse sobre o nome do warehouse na lista de itens e selecione Copy SQL connection string.
Etapa 1.6: Permitir IPs da Braze no firewall (opcional)
Dependendo da configuração da sua conta do Microsoft Fabric, pode ser necessário permitir os seguintes endereços IP no seu firewall para liberar o tráfego da Braze. Para saber mais sobre como ativar isso, consulte a documentação sobre o Acesso Condicional do Entra.
Para as instâncias US-01, US-02, US-03, US-04, US-05, US-06, US-07, estes são os endereços IP relevantes:
23.21.118.19134.206.23.17350.16.249.952.4.160.21454.87.8.3454.156.35.25152.54.89.23818.205.178.15
Para a instância US-08, estes são os endereços IP relevantes:
52.151.246.5152.170.163.18240.76.166.15740.76.166.17040.76.166.16740.76.166.16140.76.166.15640.76.166.16640.76.166.16040.88.51.7452.154.67.1740.76.166.8040.76.166.8440.76.166.8540.76.166.8140.76.166.7140.76.166.14440.76.166.145
Para a instância US-10, estes são os endereços IP relevantes:
100.25.232.16435.168.86.17952.7.44.1173.92.153.1835.172.3.12950.19.162.19
Para as instâncias EU-01 e EU-02, estes são os endereços IP relevantes:
52.58.142.24252.29.193.12135.158.29.22818.157.135.973.123.166.463.64.27.363.65.88.253.68.144.1883.70.107.88
Para a instância AU-01, estes são os endereços IP relevantes:
13.210.1.14513.211.70.15913.238.45.5452.65.73.16754.153.242.23954.206.45.213
Para a instância ID-01, estes são os endereços IP relevantes:
108.136.157.246108.137.30.20716.78.128.7116.78.14.13416.78.162.20843.218.73.35
Para a instância JP-01, estes são os endereços IP relevantes:
13.159.155.21254.199.221.24113.192.23.1654.250.120.13918.181.114.2323.114.38.100
Para a instância KR-01, estes são os endereços IP relevantes:
43.200.215.452.79.67.17552.79.113.603.34.212.9254.116.134.2313.37.197.225
Etapa 2: Criar uma nova fonte no dashboard da Braze
No dashboard da Braze, acesse Configurações de dados > Ingestão de dados na nuvem > Fontes, selecione Adicionar fonte de dados e, em seguida, selecione Snowflake.
Etapa 2.1: Adicionar as informações de conexão do Snowflake
Escolha um nome para sua fonte. Insira um Nome da credencial e selecione Workload Identity Federation ou Par de chaves, de acordo com o usuário que você criou na Etapa 1.4.
Antes de continuar, confirme o valor que você insere em Localizador de conta do Snowflake.
No campo Localizador de conta do Snowflake, insira o identificador da sua conta do Snowflake. Insira apenas o valor do identificador da conta, como myorganization-myaccount. Não inclua https://, .snowflakecomputing.com nem nenhum caminho.
Para encontrar o identificador da sua conta do Snowflake:
- No Snowsight, selecione o menu da sua conta.
- Selecione View account details.
- Copie o valor de Account identifier.
- Se você copiar de um URL do Snowflake, use apenas o valor antes de
.snowflakecomputing.com.
Etapa 2.2: Autenticar o usuário do Snowflake
No formulário de credencial, conclua as etapas na ordem:
- Insira Localizador de conta, Nome de usuário e Função.
- Selecione Criar usuário ou Alterar usuário e, em seguida, selecione Copiar instrução quando estiver disponível.
- Execute essa instrução em uma planilha do Snowflake. Para saber o que a instrução faz, consulte Configuração do Snowflake para Workload Identity Federation.
- Volte para a Braze e selecione Salvar credencial.
- Insira o warehouse, o banco de dados e o esquema, selecione Testar conexão e, em seguida, selecione Conectar à fonte.
Insira Localizador de conta, Nome de usuário e Função e, em seguida, selecione Salvar credenciais e gerar chave RSA. No Snowflake, adicione a chave pública exibida no dashboard ao usuário que você criou para a Braze.
Para saber mais sobre como fazer isso, consulte a documentação do Snowflake. Se quiser rotacionar as chaves a qualquer momento, a Braze pode gerar um novo par de chaves e fornecer a nova chave pública.
ALTER USER BRAZE_INGESTION_USER SET RSA_PUBLIC_KEY='MIIBIjANBgkqhkiG9w0BA...';
Para rotacionar a chave mais tarde, acesse Configurações de dados > Ingestão de dados na nuvem > Credenciais, abra a credencial em Credenciais de acesso a dados do Snowflake e selecione Rotacionar credencial. Para conhecer o modal de detalhes, consulte Revisar uma credencial do Snowflake.
Depois de adicionar a chave no Snowflake, selecione Testar conexão e, em seguida, selecione Conectar à fonte.
No dashboard da Braze, acesse Configurações de dados > Ingestão de dados na nuvem > Fontes, selecione Adicionar fonte de dados e, em seguida, selecione Amazon Redshift.
Etapa 2.1: Adicionar as informações de conexão do Redshift e a tabela de origem
Escolha um nome para sua fonte e insira suas credenciais e configurações do Redshift. Se estiver usando um túnel de rede privada, ative o controle deslizante e insira as informações do túnel. Em seguida, prossiga para a próxima etapa.
No dashboard da Braze, o campo Nome do banco de dados aceita apenas letras (A–Z, a–z), números (0–9) e sublinhados (_), embora o Amazon Redshift ofereça suporte a caracteres adicionais em identificadores de banco de dados.
Etapa 2.2: Testar a conexão e conectar à fonte
Em seguida, selecione Testar conexão. Quando o teste for bem-sucedido, finalize as configurações restantes e selecione Conectar à fonte. Se a conexão falhar, uma mensagem de erro aparecerá para ajudar a solucionar o problema.
Solução de problemas: Identificador de snapshot inválido
Se a Braze retornar um erro Invalid snapshot identifier durante Testar conexão ou durante a configuração da sincronização, significa que o Redshift não consegue resolver a referência de snapshot usada quando seu objeto de origem é consultado.
No Redshift, um snapshot é um backup de um cluster em um determinado momento. Cada snapshot tem um identificador exclusivo que o Redshift usa para referenciar esse estado de backup. Para saber mais, consulte Snapshots e backups do Amazon Redshift.
Esse erro pode ocorrer quando os metadados mudam enquanto a Braze valida o objeto de origem, como durante operações de cópia, restauração ou replicação de snapshots. Para saber mais, consulte como copiar snapshots para outra região da AWS e como restaurar um cluster a partir de um snapshot.
Para solucionar o problema:
- Verifique as configurações da fonte na Braze, incluindo o endpoint do cluster, o banco de dados, o esquema e o nome do objeto.
- Execute a mesma consulta diretamente no Redshift para confirmar que a tabela ou visualização pode ser lida e está estável.
- Tente novamente depois que as atividades de snapshot, restauração, redimensionamento ou replicação em andamento terminarem.
- Se o problema persistir, consulte uma visualização materializada em vez de uma tabela base que muda com frequência.
Uma visualização materializada armazena resultados de consulta pré-calculados que você pode atualizar de forma agendada, o que pode tornar as leituras mais estáveis para as sincronizações da CDI. Para saber mais, consulte visualizações materializadas no Amazon Redshift.
Exemplo:
CREATE MATERIALIZED VIEW ingestion.users_attributes_mv AS
SELECT updated_at, external_id, alias_label, alias_name, braze_id, email, phone, payload
FROM ingestion.users_attributes_sync;
REFRESH MATERIALIZED VIEW ingestion.users_attributes_mv;
Depois de criar a visualização materializada, use o nome dela como objeto de origem na sua sincronização da CDI da Braze, em vez da tabela base.
No dashboard da Braze, acesse Configurações de dados > Ingestão de dados na nuvem > Fontes, selecione Adicionar fonte de dados e, em seguida, selecione Google BigQuery.
Etapa 2.1: Adicionar as informações de conexão do BigQuery e a tabela de origem
Insira um nome para sua fonte e, em seguida, insira suas credenciais e configurações do BigQuery:
- Em Nome da credencial, insira um rótulo que ajude você a identificar essas credenciais na Braze.
- Como método de autenticação, selecione Workload Identity Federation ou Chave da conta de serviço, de acordo com as credenciais que você criou na Etapa 1.2.
- Para Workload Identity Federation, copie o ARN do principal da Braze para a configuração do Google Cloud e, em seguida, insira o Número do projeto, o ID do pool de identidade de carga de trabalho, o ID do provedor e o E-mail da conta de serviço. Para uma chave de conta de serviço, faça upload da chave JSON.
Em seguida, preencha os campos de configuração restantes.
Etapa 2.2: Testar a conexão e conectar à fonte
Em seguida, selecione Testar conexão. Quando o teste for bem-sucedido, finalize as configurações restantes e selecione Conectar à fonte. Se a conexão falhar, uma mensagem de erro aparecerá para ajudar a solucionar o problema.
No dashboard da Braze, acesse Configurações de dados > Ingestão de dados na nuvem > Fontes, selecione Adicionar fonte de dados e, em seguida, selecione Databricks.
Etapa 2.1: Adicionar as informações de conexão do Databricks e a tabela de origem
Insira um nome para sua fonte e, em seguida, insira suas credenciais e configurações do Databricks:
- Em Nome da credencial, insira um rótulo que ajude você a identificar essas credenciais na Braze.
- Em Método de autenticação, selecione OAuth M2M ou Token de acesso pessoal, de acordo com as credenciais que você criou na Etapa 1.2.
- Para OAuth M2M, insira o ID do cliente e o Segredo do cliente da sua entidade de serviço. Para um token de acesso pessoal, insira o Token de acesso.
Em seguida, prossiga para a próxima etapa.
Etapa 2.2: Testar a conexão e conectar à fonte
Em seguida, selecione Testar conexão. Quando o teste for bem-sucedido, finalize as configurações restantes e selecione Conectar à fonte. Se a conexão falhar, uma mensagem de erro aparecerá para ajudar a solucionar o problema.
Você precisa testar uma fonte com sucesso antes de criá-la. Se você fechar a página de criação, sua fonte não será salva.
No dashboard da Braze, acesse Configurações de dados > Ingestão de dados na nuvem > Fontes, selecione Adicionar fonte de dados e, em seguida, selecione Microsoft Fabric.
Etapa 2.1: Configurar uma sincronização da Ingestão de dados na nuvem
Escolha um nome para sua fonte e insira suas credenciais e configurações do Microsoft Fabric.
- Nome das credenciais é um rótulo para essas credenciais na Braze. Você pode definir aqui um valor que ajude na identificação.
- Consulte as etapas da seção 1 para saber como obter o ID do locatário, o ID do principal, o segredo do cliente e a string de conexão.
Etapa 2.2: Testar a conexão e conectar à fonte
Em seguida, selecione Testar conexão. Quando o teste for bem-sucedido, finalize as configurações restantes e selecione Conectar à fonte. Se a conexão falhar, uma mensagem de erro aparecerá para ajudar a solucionar o problema.
Você precisa testar uma fonte com sucesso antes de criá-la. Se você fechar a página de criação, sua fonte não será salva.
Etapa 3: Criar uma nova sincronização no dashboard da Braze
Acesse Configurações de dados > Ingestão de dados na nuvem > Sincronizações e selecione Criar sincronização de dados.
Etapa 3.1: Configurar os detalhes da sincronização e definir seus dados
Insira um nome para sua sincronização. Em seguida, selecione uma fonte ativa e um tipo de dados de sincronização. Depois, selecione Visual ou Tabela e insira sua tabela de origem, ou selecione SQL para escrever uma consulta SQL personalizada. Por fim, selecione Prévia e validação.
Depois que a validação for bem-sucedida, uma prévia dos dados aparecerá. Selecione Próximo: Notificações para continuar. Se a validação falhar, uma mensagem de erro aparecerá para ajudar a solucionar o problema.
Você precisa validar uma sincronização com sucesso antes de avançar para as próximas etapas. Se precisar sair da página de criação da sincronização, selecione Salvar como rascunho para manter o trabalho em andamento.
Etapa 3.2: Adicionar preferências de notificação
Insira um ou mais e-mails de contato para notificações de erro de sincronização. A Braze usa essas informações de contato para enviar notificações sobre erros de integração, como a perda inesperada de acesso à tabela.
Os e-mails de contato recebem apenas notificações de erros globais ou no nível da sincronização, como tabelas ausentes, permissões e outros. Eles não recebem problemas no nível da linha. Erros globais indicam problemas críticos na conexão que impedem a execução das sincronizações.
Esses problemas podem incluir:
- Problemas de conectividade
- Falta de recursos
- Problemas de permissão
- Falta de espaço no nível do catálogo (somente sincronizações de catálogo)
Etapa 3.3: Agendamento
Por fim, configure sua sincronização como não recorrente ou recorrente.
As sincronizações não recorrentes são executadas apenas quando você seleciona Sincronizar agora no dashboard ou chama o endpoint Disparar uma sincronização.
As sincronizações recorrentes podem ser executadas com frequência de até a cada 5 minutos ou tão raramente quanto uma vez por mês. Por padrão, o menor intervalo que você pode definir no dashboard é de 15 minutos, o que ajuda a gerenciar os custos de computação do seu warehouse e o volume de solicitações. Para sincronizar a cada 5 minutos, entre em contato com o suporte da Braze ou com seu gerente de sucesso do cliente. A Braze agenda as sincronizações recorrentes em UTC.
Etapa 3.1: Configurar os detalhes da sincronização e definir seus dados
Insira um nome para sua sincronização. Em seguida, selecione uma fonte ativa e um tipo de dados de sincronização. Depois, selecione Visual ou Tabela e insira sua tabela de origem, ou selecione SQL para escrever uma consulta SQL personalizada. Por fim, selecione Prévia e validação.
Depois que a validação for bem-sucedida, uma prévia dos dados aparecerá. Selecione Próximo: Notificações para continuar. Se a validação falhar, uma mensagem de erro aparecerá para ajudar a solucionar o problema.
Você precisa validar uma sincronização com sucesso antes de avançar para as próximas etapas. Se precisar sair da página de criação da sincronização, selecione Salvar como rascunho para manter o trabalho em andamento.
Etapa 3.2: Adicionar preferências de notificação
Insira um ou mais e-mails de contato para notificações de erro de sincronização. A Braze usa essas informações de contato para enviar notificações sobre erros de integração, como a perda inesperada de acesso à tabela.
Os e-mails de contato recebem apenas notificações de erros globais ou no nível da sincronização, como tabelas ausentes, permissões e outros. Eles não recebem problemas no nível da linha. Erros globais indicam problemas críticos na conexão que impedem a execução das sincronizações. Esses problemas podem incluir:
- Problemas de conectividade
- Falta de recursos
- Problemas de permissão
- Falta de espaço no nível do catálogo (somente sincronizações de catálogo)
Etapa 3.3: Agendamento
Por fim, configure sua sincronização como não recorrente ou recorrente.
As sincronizações não recorrentes são executadas apenas quando você seleciona Sincronizar agora no dashboard ou chama o endpoint Disparar uma sincronização.
As sincronizações recorrentes podem ser executadas com frequência de até a cada 5 minutos ou tão raramente quanto uma vez por mês. Por padrão, o menor intervalo que você pode definir no dashboard é de 15 minutos, o que ajuda a gerenciar os custos de computação do seu warehouse e o volume de solicitações. Para sincronizar a cada 5 minutos, entre em contato com o suporte da Braze ou com seu gerente de sucesso do cliente. A Braze agenda as sincronizações recorrentes em UTC.
Etapa 3.1: Configurar os detalhes da sincronização e definir seus dados
Insira um nome para sua sincronização. Em seguida, selecione uma fonte ativa e um tipo de dados de sincronização. Depois, selecione Visual ou Tabela e insira sua tabela de origem, ou selecione SQL para escrever uma consulta SQL personalizada. Por fim, selecione Prévia e validação.
Depois que a validação for bem-sucedida, uma prévia dos dados aparecerá. Selecione Próximo: Notificações para continuar. Se a validação falhar, uma mensagem de erro aparecerá para ajudar a solucionar o problema.
Você precisa validar uma sincronização com sucesso antes de avançar para as próximas etapas. Se precisar sair da página de criação da sincronização, selecione Salvar como rascunho para manter o trabalho em andamento.
Etapa 3.2: Adicionar preferências de notificação
Insira um ou mais e-mails de contato para notificações de erro de sincronização. A Braze usa essas informações de contato para enviar notificações sobre erros de integração, como a perda inesperada de acesso à tabela.
Os e-mails de contato recebem apenas notificações de erros globais ou no nível da sincronização, como tabelas ausentes, permissões e outros. Eles não recebem problemas no nível da linha. Erros globais indicam problemas críticos na conexão que impedem a execução das sincronizações.
Esses problemas podem incluir:
- Problemas de conectividade
- Falta de recursos
- Problemas de permissão
- Falta de espaço no nível do catálogo (somente sincronizações de catálogo)
Etapa 3.3: Agendamento
Por fim, configure sua sincronização como não recorrente ou recorrente.
As sincronizações não recorrentes são executadas apenas quando você seleciona Sincronizar agora no dashboard ou chama o endpoint Disparar uma sincronização.
As sincronizações recorrentes podem ser executadas com frequência de até a cada 5 minutos ou tão raramente quanto uma vez por mês. Por padrão, o menor intervalo que você pode definir no dashboard é de 15 minutos, o que ajuda a gerenciar os custos de computação do seu warehouse e o volume de solicitações. Para sincronizar a cada 5 minutos, entre em contato com o suporte da Braze ou com seu gerente de sucesso do cliente. A Braze agenda as sincronizações recorrentes em UTC.
Etapa 3.1: Configurar os detalhes da sincronização e definir seus dados
Insira um nome para sua sincronização. Em seguida, selecione uma fonte ativa e um tipo de dados de sincronização. Depois, selecione Visual ou Tabela e insira sua tabela de origem, ou selecione SQL para escrever uma consulta SQL personalizada. Por fim, selecione Prévia e validação.
Depois que a validação for bem-sucedida, uma prévia dos dados aparecerá. Selecione Próximo: Notificações para continuar. Se a validação falhar, uma mensagem de erro aparecerá para ajudar a solucionar o problema.
Você precisa validar uma sincronização com sucesso antes de avançar para as próximas etapas. Se precisar sair da página de criação da sincronização, selecione Salvar como rascunho para manter o trabalho em andamento.
Etapa 3.2: Adicionar preferências de notificação
Insira um ou mais e-mails de contato para notificações de erro de sincronização. A Braze usa essas informações de contato para enviar notificações sobre erros de integração, como a perda inesperada de acesso à tabela.
Os e-mails de contato recebem apenas notificações de erros globais ou no nível da sincronização, como tabelas ausentes, permissões e outros. Eles não recebem problemas no nível da linha. Erros globais indicam problemas críticos na conexão que impedem a execução das sincronizações.
Esses problemas podem incluir:
- Problemas de conectividade
- Falta de recursos
- Problemas de permissão
- Falta de espaço no nível do catálogo (somente sincronizações de catálogo)
Etapa 3.3: Agendamento
Por fim, configure sua sincronização como não recorrente ou recorrente.
As sincronizações não recorrentes são executadas apenas quando você seleciona Sincronizar agora no dashboard ou chama o endpoint Disparar uma sincronização.
As sincronizações recorrentes podem ser executadas com frequência de até a cada 5 minutos ou tão raramente quanto uma vez por mês. Por padrão, o menor intervalo que você pode definir no dashboard é de 15 minutos, o que ajuda a gerenciar os custos de computação do seu warehouse e o volume de solicitações. Para sincronizar a cada 5 minutos, entre em contato com o suporte da Braze ou com seu gerente de sucesso do cliente. A Braze agenda as sincronizações recorrentes em UTC.
Você precisa validar uma integração com sucesso antes que ela passe do estado Rascunho para Ativo. Se você fechar a página de criação, sua integração será salva, e você poderá voltar à página de detalhes para fazer alterações e validá-la.
Configure integrações ou usuários adicionais (opcional)
Você pode configurar várias integrações com a Braze. Ao criar sincronizações adicionais, você pode reutilizar credenciais existentes se estiver se conectando à conta do Snowflake.
Se você reutilizar o mesmo usuário e a mesma função de par de chaves entre integrações, não precisa adicionar a chave pública novamente. Uma credencial de Workload Identity Federation não tem chave pública para adicionar.
Você pode configurar várias integrações com a Braze. Ao criar sincronizações adicionais, você pode reutilizar credenciais existentes se estiver se conectando à mesma conta do Redshift.
Se você reutilizar o mesmo usuário entre integrações, não poderá excluir o usuário no dashboard da Braze até que ele seja removido de todas as sincronizações ativas.
Você pode configurar várias integrações com a Braze. Ao criar sincronizações adicionais, você pode reutilizar credenciais existentes se estiver se conectando à mesma conta do BigQuery.
Se você reutilizar o mesmo usuário entre integrações, não poderá excluir o usuário no dashboard da Braze até que ele seja removido de todas as sincronizações ativas.
Você pode configurar várias integrações com a Braze. Ao criar sincronizações adicionais, você pode reutilizar credenciais existentes se estiver se conectando à mesma conta do Databricks.
Se você reutilizar o mesmo usuário entre integrações, não poderá excluir o usuário no dashboard da Braze até que ele seja removido de todas as sincronizações ativas.
Você pode configurar várias integrações com a Braze. Ao criar sincronizações adicionais, você pode reutilizar credenciais existentes se estiver se conectando à mesma conta do Fabric.
Se você reutilizar o mesmo usuário entre integrações, não poderá excluir o usuário no dashboard da Braze até que ele seja removido de todas as sincronizações ativas.
Executando a sincronização
Depois de ativada, a sincronização é executada no cronograma configurado durante a configuração. Se quiser executar a sincronização fora do cronograma ou buscar os dados mais recentes, selecione Sincronizar agora. Essa execução não afeta as próximas sincronizações agendadas regularmente. Para iniciar uma sincronização automaticamente quando seus dados forem atualizados, chame o endpoint Disparar uma sincronização a partir do seu pipeline.
Depois de ativada, a sincronização é executada no cronograma configurado durante a configuração. Se quiser executar a sincronização fora do cronograma ou buscar os dados mais recentes, selecione Sincronizar agora. Essa execução não afeta as próximas sincronizações agendadas regularmente. Para iniciar uma sincronização automaticamente quando seus dados forem atualizados, chame o endpoint Disparar uma sincronização a partir do seu pipeline.
Depois de ativada, a sincronização é executada no cronograma configurado durante a configuração. Se quiser executar a sincronização fora do cronograma ou buscar os dados mais recentes, selecione Sincronizar agora. Essa execução não afeta as próximas sincronizações agendadas regularmente. Para iniciar uma sincronização automaticamente quando seus dados forem atualizados, chame o endpoint Disparar uma sincronização a partir do seu pipeline.
Depois de ativada, a sincronização é executada no cronograma configurado durante a configuração. Se quiser executar a sincronização fora do cronograma ou buscar os dados mais recentes, selecione Sincronizar agora. Essa execução não afeta as próximas sincronizações agendadas regularmente. Para iniciar uma sincronização automaticamente quando seus dados forem atualizados, chame o endpoint Disparar uma sincronização a partir do seu pipeline.
Depois de ativada, a sincronização é executada no cronograma configurado durante a configuração. Se quiser executar a sincronização fora do cronograma ou buscar os dados mais recentes, selecione Sincronizar agora. Essa execução não afeta as próximas sincronizações agendadas regularmente. Para iniciar uma sincronização automaticamente quando seus dados forem atualizados, chame o endpoint Disparar uma sincronização a partir do seu pipeline.